
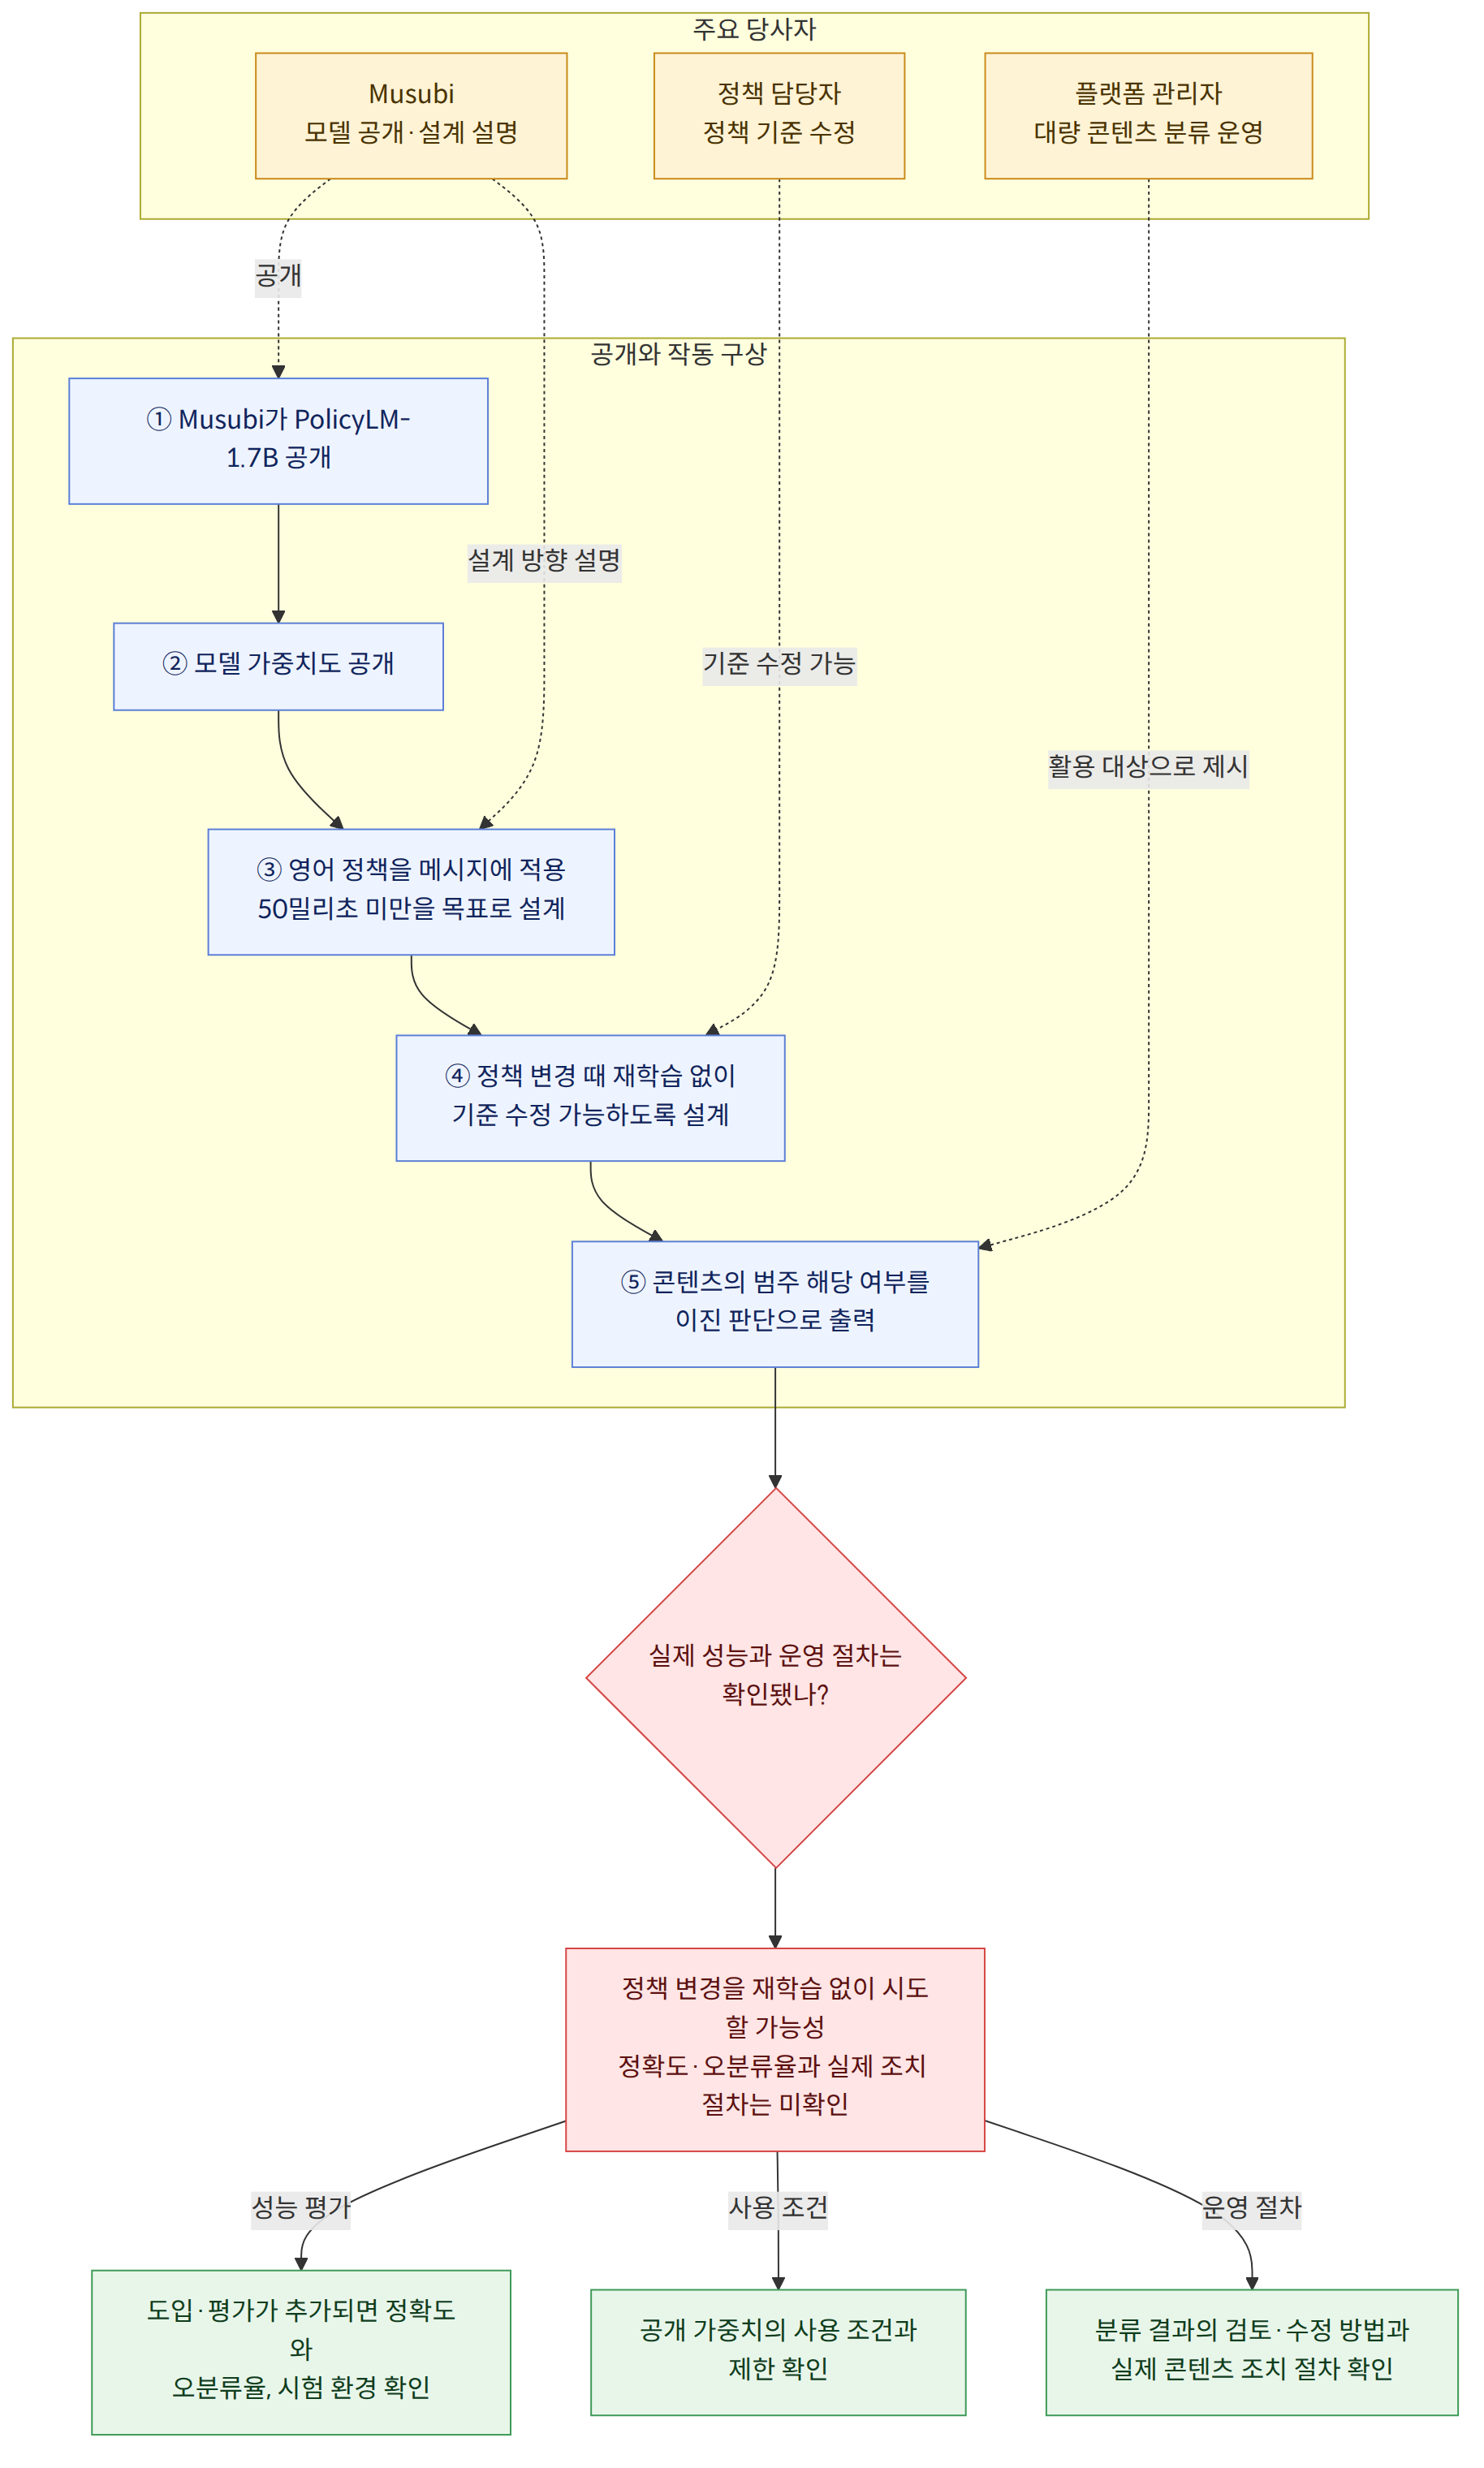
Musubi가 화요일 실시간 콘텐츠 조정용 경량 모델 PolicyLM-1.7B를 공개하고 모델 가중치도 공개했다. 회사가 제시한 구상은 영어로 작성된 콘텐츠 정책을 메시지에 적용해 50밀리초 미만에 결과를 내는 것이다. 정책이 바뀔 때마다 모델을 새로 학습하지 않고도 기준을 수정할 수 있도록 설계했다는 점이 핵심이다.
배경과 맥락
Musubi는 PolicyLM-1.7B가 대부분의 소셜 플랫폼에서 콘텐츠 조정에 쓰이는 AI 분류기와 비슷한 비용과 속도를 내도록 설계됐다고 밝혔다. 동시에 최신 대규모언어모델(LLM)의 유연성을 활용해 복잡한 정책도 별도의 특별 학습 없이 적용하는 것을 목표로 한다고 설명했다. 이 설명은 모델의 설계 방향에 관한 것으로, 실제 플랫폼에서 같은 성능이 확인됐다는 뜻은 아니다.
회사 설명대로라면 정책을 정하는 담당자는 기준을 바꿀 때마다 모델을 다시 학습시키지 않고 필요에 따라 정책을 반복해서 수정할 수 있다. 이는 콘텐츠 조정에서 ‘판정 기준을 바꾸는 일’과 ‘모델을 다시 훈련하는 일’을 분리하려는 접근이다. 콘텐츠가 많아지고 정책도 조정될 수 있는 상황에서, 새 기준을 적용하는 데 재학습이 필수인 구조보다 운영 변경을 빠르게 시도할 여지가 생길 수 있다.
이 모델이 속한 의사결정 모델은 일반적인 대규모언어모델처럼 문장을 생성하는 대신, 정해진 선택지에 맞춰 결과를 내도록 설계된 유형이다. 원문은 의사결정 모델이 보통 결과 확률을 출력한다고 설명하면서, PolicyLM-1.7B는 콘텐츠가 특정 범주에 속하는지 아닌지를 이진 판단으로 출력한다고 구분한다. 출력 선택지를 제한하면 대규모언어모델보다 빠르고 저렴하게 실행하면서도 트랜스포머 구조의 유연성을 유지할 수 있다는 것이 원문의 설명이다.
의사결정 모델은 TypeSafe AI가 9월 Jev를 공개한 뒤 주목을 받았고, OpenAI와 Amazon도 경쟁 모델을 내놓았다고 원문은 전했다. Musubi 공동창업자이자 최고AI책임자인 필립 얀코비치는 자신이 이 방식에 관심을 가진 시점은 Jev 공개보다 앞선다고 말했다. 그는 같은 기법을 여럿 활용한 2024년 프로젝트 GLiNER를 그 기원으로 들었다.
이 소식이 뜻하는 것
콘텐츠 조정은 정책을 정하는 일뿐 아니라, 플랫폼에 올라오는 메시지를 그 기준에 따라 분류하는 일도 포함한다. PolicyLM-1.7B의 설계가 의도대로 작동한다면, 정책 변경 때 모델 재학습을 기다리지 않고 새 기준을 적용할 수 있다는 점에서 대량의 콘텐츠를 다루는 플랫폼 관리자에게 운영상의 선택지를 늘릴 수 있다. 얀코비치는 이 모델이 관리자에게 콘텐츠를 선제적으로 분류할 방법을 제공한다고 설명했다.
다만 ‘분류’와 ‘제재’는 같은 말이 아니다. 원문이 설명하는 모델 출력은 콘텐츠가 특정 범주에 해당하는지에 대한 판단이다. 그 판단이 실제로 게시물 삭제나 이용자 제재로 이어지는지, 사람이 결과를 검토하는지 등 운영 절차는 원문에서 확인되지 않는다. 따라서 이 모델이 곧바로 어떤 콘텐츠 조치를 자동화한다고 단정하기보다, 조정 기준에 따라 콘텐츠를 구분하는 도구로 소개됐다는 점을 구별해서 볼 필요가 있다.
예를 들어 어떤 플랫폼이 기존 정책의 문구를 바꿔 새 기준을 적용하려 한다면, Musubi의 설명대로라면 모델을 다시 학습하는 절차 없이 정책 자체를 수정해 적용할 수 있다. 이는 운영자가 기준을 고쳐 적용하는 과정을 간소화할 가능성을 보여준다. 그러나 바뀐 기준을 모델이 얼마나 정확하게 적용하는지, 잘못 분류된 콘텐츠를 어떻게 바로잡는지는 공개된 내용만으로 판단할 수 없다.
확인된 사실과 아직 알 수 없는 것
확인된 사실
- Musubi는 화요일 PolicyLM-1.7B를 공개했고 모델 가중치도 공개했다.
- 이 모델은 영어 콘텐츠 정책을 메시지에 50밀리초 미만으로 적용하도록 설계됐다.
- Musubi는 정책 변경 때 재학습 없이 담당자가 정책을 수정할 수 있다고 설명했다.
- PolicyLM-1.7B는 콘텐츠가 특정 범주에 속하는지를 이진 판단으로 출력하는 것으로 소개됐다.
아직 알 수 없는 것
- 실제 조정 정확도와 오분류율은 어느 정도인가?
- 어떤 플랫폼이나 콘텐츠 유형에서 시험됐으며, 그 결과는 무엇인가?
- 공개된 모델 가중치에는 어떤 사용 조건이나 제한이 적용되는가?
독자가 확인할 것
- 실제 도입 소식이나 성능 평가가 추가로 나올 경우, 정확도뿐 아니라 콘텐츠를 잘못 분류하는 비율과 시험한 환경도 함께 확인할 필요가 있다.
- 공개 가중치를 직접 활용하려는 경우에는 적용되는 사용 조건과 제한을 확인해야 한다. 현재 원문은 그 세부 조건을 제시하지 않는다.
- 플랫폼이 이 모델을 도입한다면, 모델의 분류 결과가 실제 콘텐츠 조치로 이어지는 절차와 결과를 검토·수정할 방법이 공개되는지도 살펴볼 만하다.

















