
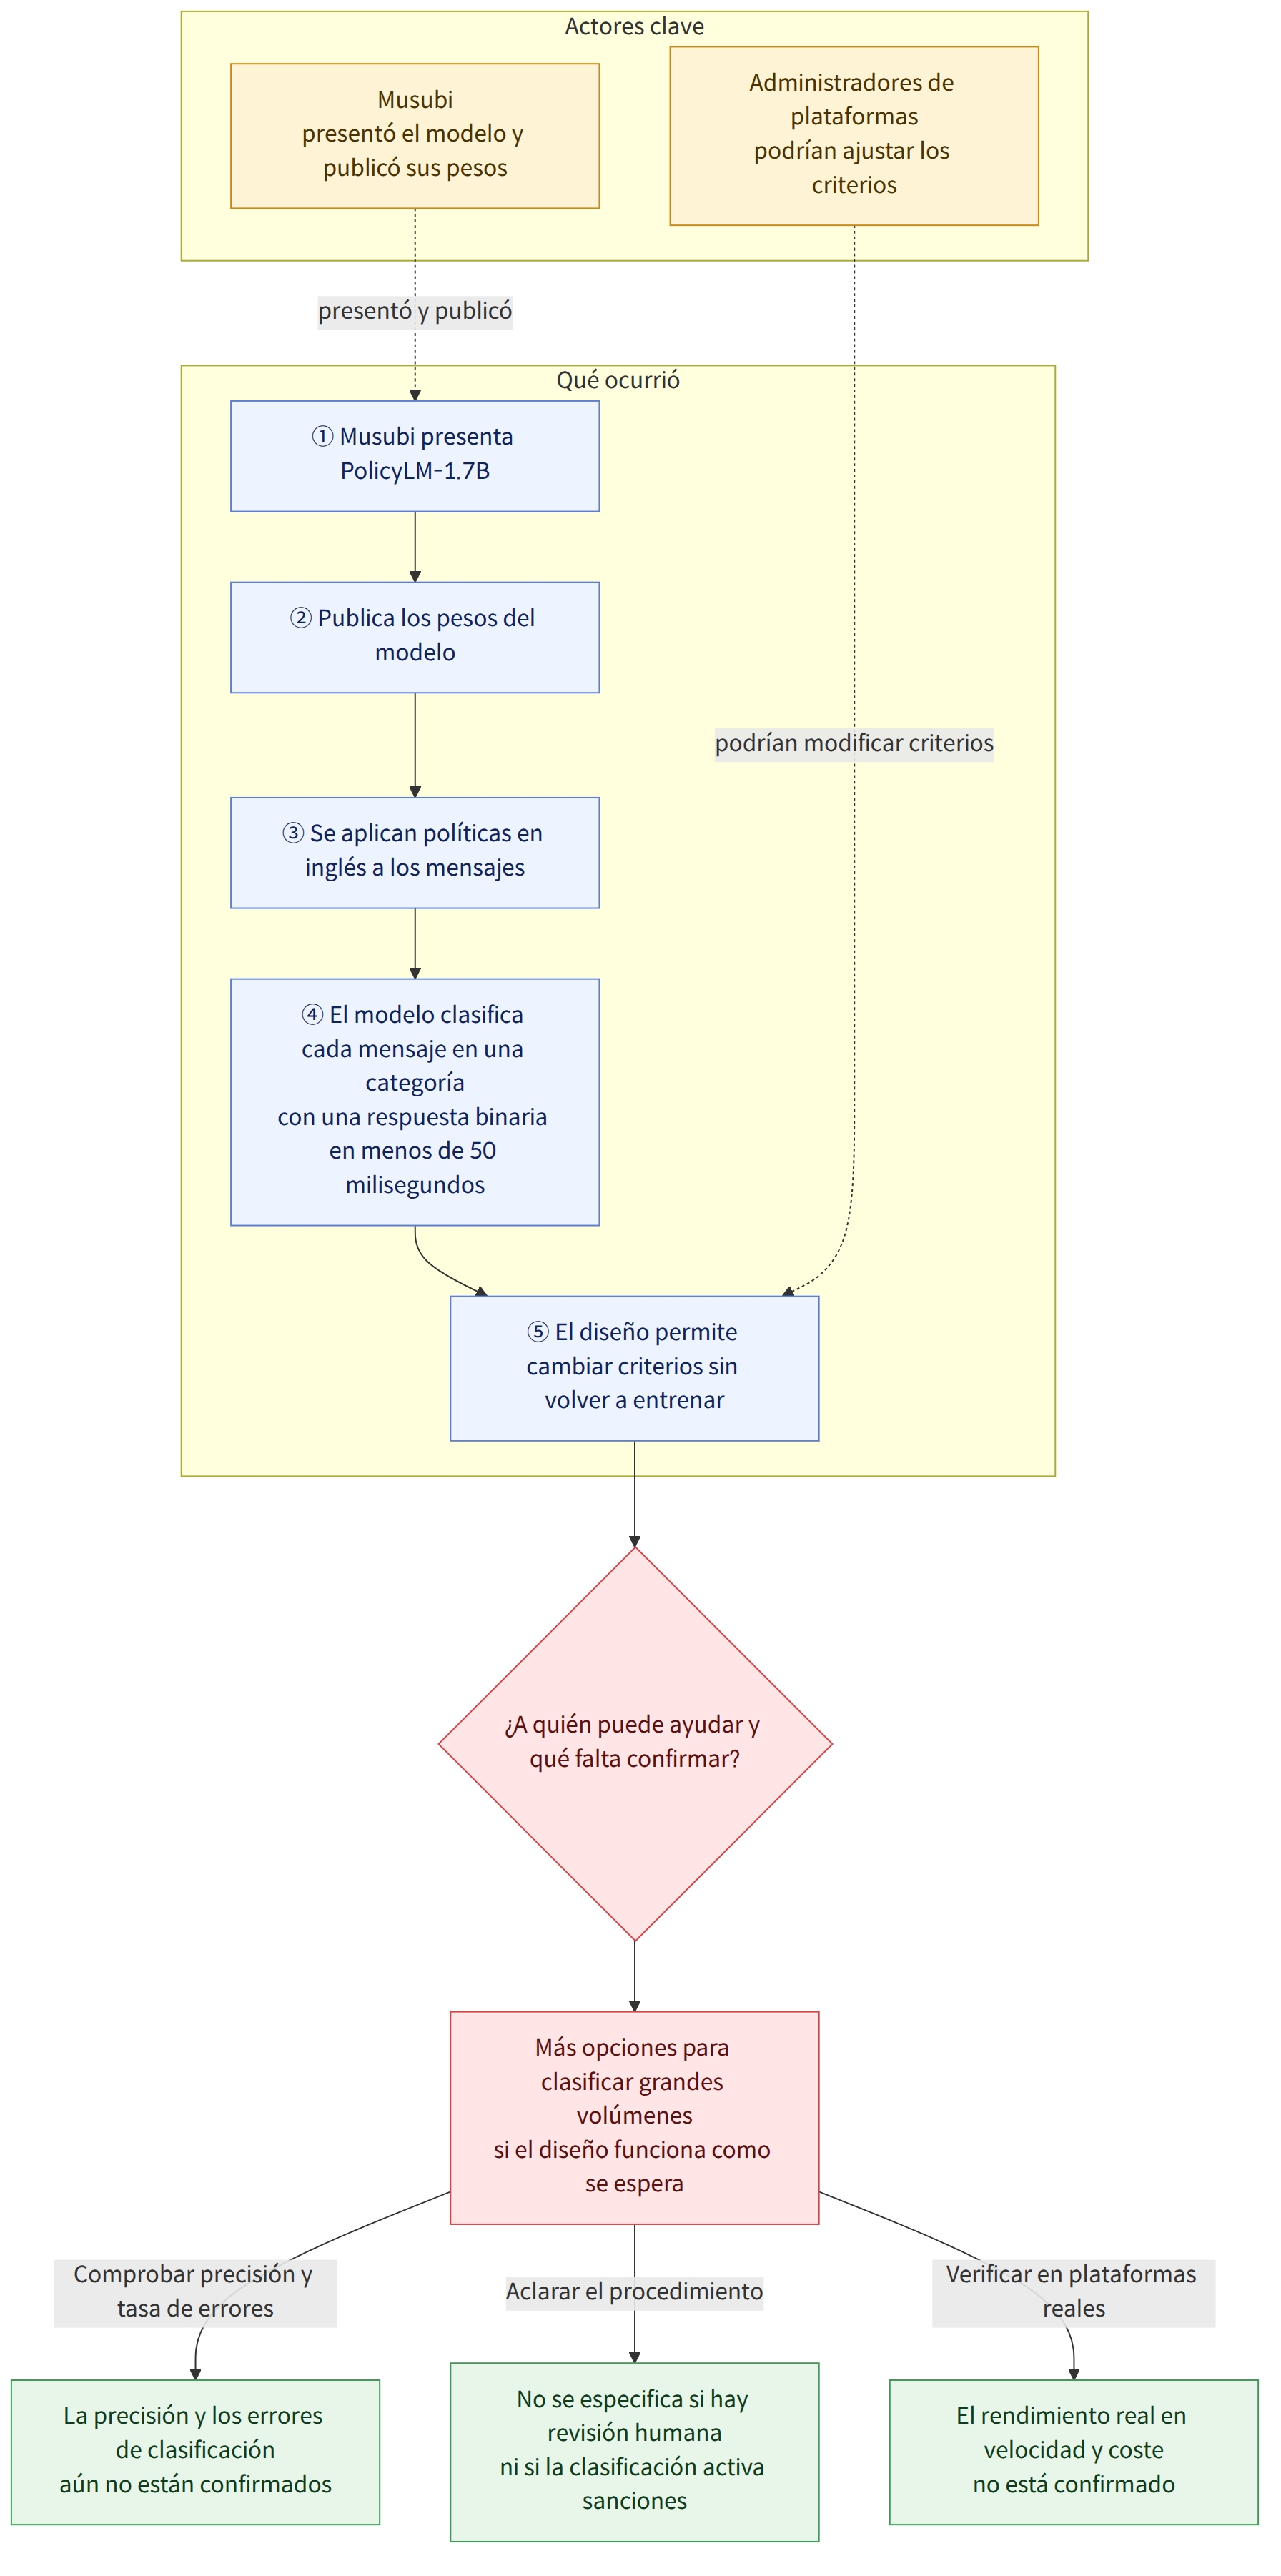
Musubi presentó el martes PolicyLM-1.7B, un modelo ligero para moderar contenido en tiempo real, y publicó también sus pesos. La propuesta de la empresa consiste en aplicar políticas de contenido redactadas en inglés a los mensajes y obtener un resultado en menos de 50 milisegundos. La clave es que el modelo está diseñado para permitir cambios en los criterios sin tener que volver a entrenarlo cada vez que cambien las políticas.
Antecedentes y contexto
Musubi afirmó que PolicyLM-1.7B está diseñado para ofrecer un coste y una velocidad similares a los de los clasificadores de inteligencia artificial que se utilizan para moderar contenido en la mayoría de las plataformas sociales. Al mismo tiempo, explicó que el objetivo es aprovechar la flexibilidad de los modelos de lenguaje de gran tamaño (LLM) más recientes para aplicar incluso políticas complejas sin un entrenamiento especial. Esta descripción se refiere al diseño del modelo y no significa que se haya confirmado que alcance el mismo rendimiento en plataformas reales.
Según la empresa, quienes establecen las políticas podrían modificarlas según fuera necesario sin volver a entrenar el modelo cada vez que cambiaran los criterios. Se trata de un enfoque que busca separar «cambiar los criterios de decisión» de «volver a entrenar el modelo» en la moderación de contenido. En una situación en la que aumentan tanto el volumen de contenido como la posibilidad de ajustar las políticas, esto podría facilitar que se prueben cambios operativos con rapidez, en vez de depender de una estructura que exija volver a entrenar el modelo para aplicar nuevos criterios.
El modelo pertenece a la categoría de modelos de decisión, diseñados para producir resultados entre opciones predeterminadas, en lugar de generar texto como los modelos de lenguaje de gran tamaño convencionales. El texto original explica que los modelos de decisión suelen generar probabilidades para distintos resultados, mientras que PolicyLM-1.7B determina de forma binaria si un contenido pertenece o no a una categoría concreta. Según el texto original, limitar las opciones de respuesta permite ejecutarlo con mayor rapidez y a menor coste que un modelo de lenguaje de gran tamaño, sin perder la flexibilidad de la arquitectura transformer.
Los modelos de decisión despertaron interés después de que TypeSafe AI presentara Jev en septiembre, y el texto original informó de que OpenAI y Amazon también lanzaron modelos competidores. Philip Jankowicz, cofundador y director de IA de Musubi, dijo que se interesó por este enfoque antes de la presentación de Jev. Citó como origen el proyecto GLiNER de 2024, que utilizó varias técnicas similares.
Qué significa esta noticia
La moderación de contenido no solo consiste en establecer políticas, sino también en clasificar los mensajes que se publican en una plataforma según esos criterios. Si el diseño de PolicyLM-1.7B funciona como se espera, los administradores de plataformas que gestionan grandes volúmenes de contenido podrían contar con más opciones operativas, ya que sería posible aplicar nuevos criterios sin esperar a que se vuelva a entrenar el modelo. Jankowicz explicó que el modelo ofrece a los administradores una forma de clasificar el contenido de manera proactiva.
Sin embargo, «clasificación» y «sanción» no significan lo mismo. La salida que describe el texto original es un juicio sobre si el contenido pertenece a una categoría determinada. El texto no aclara si ese juicio lleva a eliminar publicaciones o sancionar a usuarios, ni si una persona revisa los resultados, entre otros aspectos del procedimiento operativo. Por tanto, conviene distinguir entre presentar el modelo como una herramienta para clasificar contenido según criterios de moderación y afirmar que automatiza directamente alguna medida sobre el contenido.
Por ejemplo, si una plataforma quisiera modificar la redacción de una política existente para aplicar nuevos criterios, según Musubi podría cambiar y aplicar la propia política sin tener que volver a entrenar el modelo. Esto apunta a la posibilidad de simplificar el proceso mediante el cual los responsables modifican y aplican los criterios. Sin embargo, con la información publicada no se puede determinar con qué precisión aplicaría el modelo los criterios modificados ni cómo se corregiría la clasificación errónea de contenido.
Hechos confirmados y aspectos aún desconocidos
Hechos confirmados
- Musubi presentó PolicyLM-1.7B el martes y publicó también los pesos del modelo.
- El modelo está diseñado para aplicar políticas de contenido en inglés a los mensajes en menos de 50 milisegundos.
- Musubi explicó que los responsables pueden modificar las políticas sin volver a entrenar el modelo cuando estas cambien.
- PolicyLM-1.7B se presentó como un modelo que determina de forma binaria si el contenido pertenece a una categoría concreta.
Aspectos aún desconocidos
- ¿Cuál es su precisión real al moderar contenido y cuál es su tasa de errores de clasificación?
- ¿En qué plataformas o tipos de contenido se probó y cuáles fueron los resultados?
- ¿Qué condiciones o restricciones de uso se aplican a los pesos del modelo publicados?
Qué deben comprobar los lectores
- Si se publican noticias sobre su adopción o evaluaciones de rendimiento, conviene comprobar no solo la precisión, sino también la tasa de clasificaciones erróneas y el entorno en el que se realizaron las pruebas.
- Quienes quieran utilizar directamente los pesos publicados deben consultar las condiciones y restricciones de uso aplicables. El texto original no especifica actualmente esos detalles.
- Si una plataforma adopta el modelo, también será importante comprobar si se hacen públicos los procedimientos por los que sus clasificaciones dan lugar a medidas sobre el contenido y los métodos para revisar y corregir los resultados.

















