
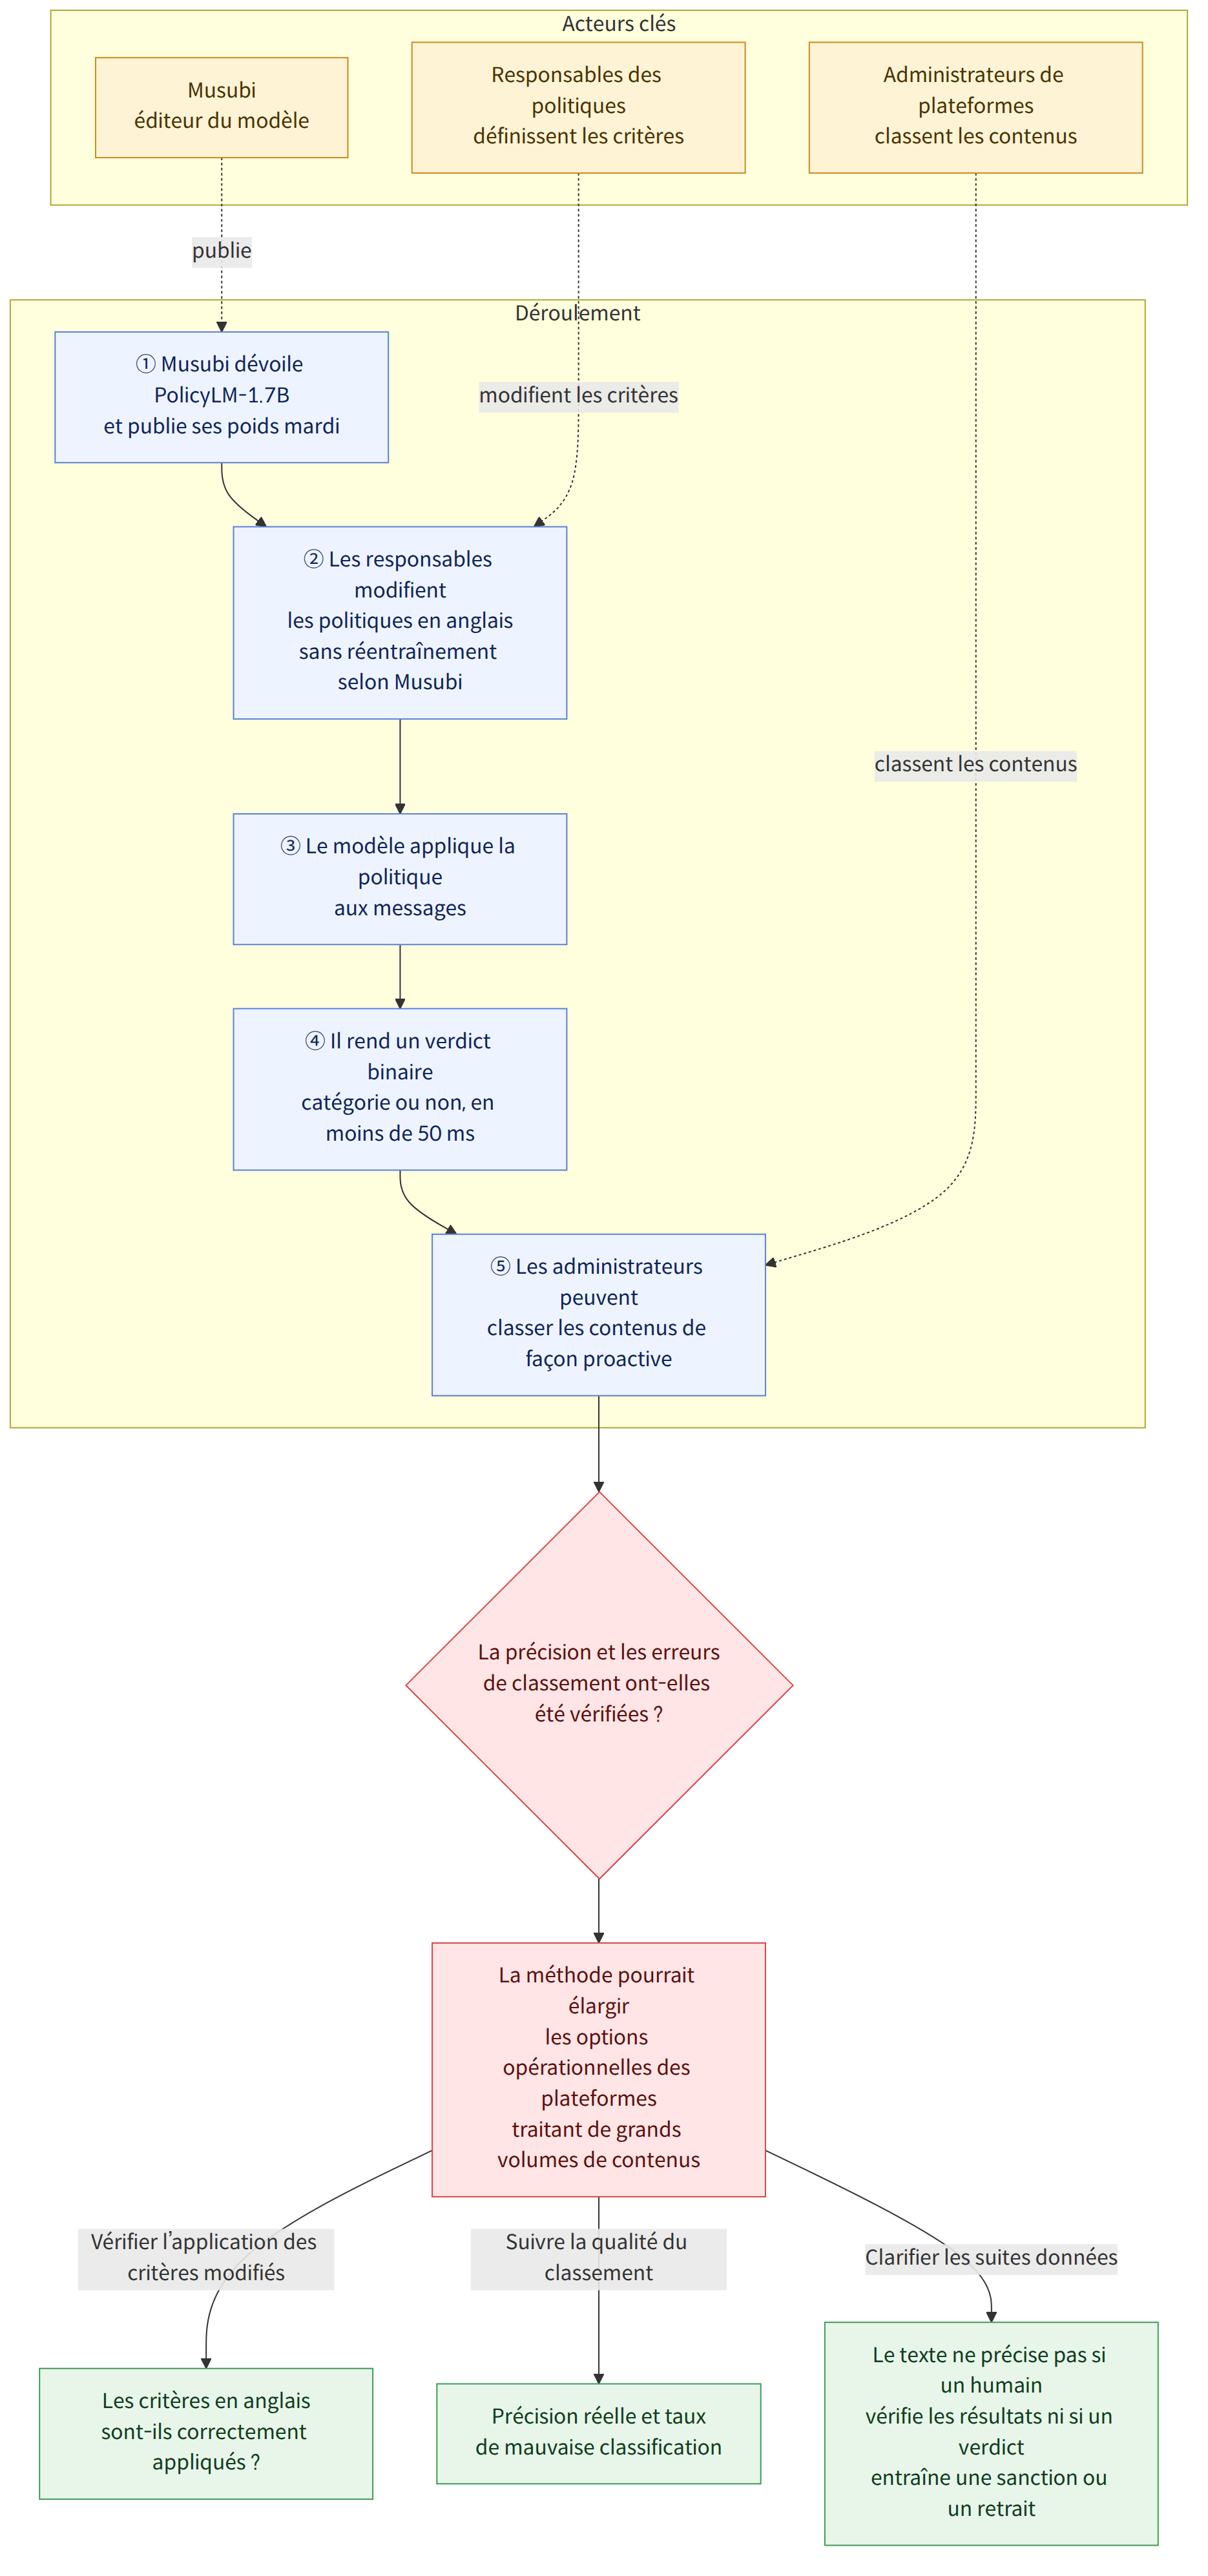
Mardi, Musubi a dévoilé PolicyLM-1.7B, un modèle léger destiné à la modération de contenu en temps réel, et a également publié les poids du modèle. L’entreprise entend appliquer des politiques de contenu rédigées en anglais aux messages et produire un résultat en moins de 50 millisecondes. Le point essentiel est que le modèle a été conçu pour permettre de modifier les critères sans devoir le réentraîner à chaque changement de politique.
Contexte
Musubi a indiqué que PolicyLM-1.7B avait été conçu pour offrir un coût et une vitesse comparables à ceux des classificateurs d’IA utilisés pour la modération de contenu sur la plupart des plateformes sociales. L’entreprise explique également vouloir tirer parti de la flexibilité des grands modèles de langage (LLM) récents afin d’appliquer des politiques complexes sans entraînement spécifique supplémentaire. Cette description porte sur l’orientation de conception du modèle et ne signifie pas que des performances équivalentes ont été vérifiées sur des plateformes réelles.
Selon l’entreprise, les responsables chargés de définir les politiques peuvent modifier celles-ci à leur guise sans réentraîner le modèle à chaque changement de critère. L’approche vise à dissocier, pour la modération de contenu, la « modification des critères de décision » du « réentraînement du modèle ». Lorsque les volumes de contenu augmentent et que les politiques sont susceptibles d’évoluer, cette méthode pourrait permettre de tester plus rapidement des changements opérationnels qu’un système où le réentraînement est indispensable pour appliquer de nouveaux critères.
Le modèle appartient à la catégorie des modèles de décision, conçus pour produire des résultats parmi des options prédéfinies plutôt que de générer du texte comme le font les grands modèles de langage classiques. Le texte source indique que les modèles de décision produisent généralement des probabilités de résultat, tandis que PolicyLM-1.7B rend un verdict binaire : le contenu appartient ou non à une catégorie donnée. Selon le texte source, limiter les choix de sortie permet de faire fonctionner le modèle plus rapidement et à moindre coût qu’un grand modèle de langage, tout en conservant la flexibilité de l’architecture Transformer.
Les modèles de décision ont suscité de l’intérêt après la présentation de Jev par TypeSafe AI en septembre. Le texte source rapporte qu’OpenAI et Amazon ont également lancé des modèles concurrents. Philip Jankowicz, cofondateur et directeur de l’IA de Musubi, a déclaré qu’il s’intéressait à cette approche avant la présentation de Jev. Il a cité comme point de départ le projet GLiNER, mené en 2024 et faisant appel à plusieurs techniques similaires.
Ce que cette annonce signifie
La modération de contenu ne consiste pas seulement à définir des politiques : elle implique aussi de classer les messages publiés sur une plateforme selon ces critères. Si le modèle fonctionne comme prévu, la possibilité d’appliquer de nouveaux critères sans attendre le réentraînement du modèle pourrait offrir davantage d’options opérationnelles aux responsables de plateformes qui traitent de grandes quantités de contenu. Jankowicz a expliqué que le modèle permettait aux administrateurs de classer les contenus de manière proactive.
Toutefois, « classification » et « sanction » ne sont pas synonymes. Le résultat décrit dans le texte source indique si un contenu relève d’une catégorie donnée. Le texte ne précise pas si cette décision entraîne concrètement la suppression d’une publication ou une sanction à l’encontre d’un utilisateur, ni si une personne vérifie les résultats. Il convient donc de distinguer cet outil, présenté comme un moyen de classer des contenus selon des critères de modération, de l’affirmation selon laquelle il automatiserait directement certaines mesures à l’égard des contenus.
Par exemple, si une plateforme souhaite modifier le libellé d’une politique existante pour appliquer de nouveaux critères, elle pourrait, selon les explications de Musubi, modifier la politique elle-même et l’appliquer sans réentraîner le modèle. Cela montre que le processus par lequel les responsables modifient et appliquent les critères pourrait être simplifié. Cependant, les informations publiées ne permettent pas de déterminer dans quelle mesure le modèle applique correctement les critères modifiés ni comment les contenus mal classés sont rectifiés.
Faits établis et questions en suspens
Faits établis
- Musubi a dévoilé PolicyLM-1.7B mardi et a également publié les poids du modèle.
- Le modèle a été conçu pour appliquer des politiques de contenu en anglais aux messages en moins de 50 millisecondes.
- Musubi explique que les responsables peuvent modifier les politiques sans réentraîner le modèle lorsque celles-ci changent.
- PolicyLM-1.7B est présenté comme produisant un verdict binaire indiquant si un contenu appartient ou non à une catégorie donnée.
Questions en suspens
- Quelle est sa précision réelle en matière de modération et quel est son taux de mauvaise classification ?
- Sur quelles plateformes ou quels types de contenus a-t-il été testé, et quels ont été les résultats ?
- Quelles conditions d’utilisation ou restrictions s’appliquent aux poids du modèle publiés ?
Points à suivre
- Si de nouvelles informations sur son déploiement ou des évaluations de ses performances sont publiées, il faudra examiner non seulement sa précision, mais aussi le taux de contenus mal classés et les conditions dans lesquelles les tests ont été menés.
- Toute personne souhaitant utiliser directement les poids publiés devra vérifier les conditions d’utilisation et les restrictions applicables. Le texte source ne précise pas ces modalités.
- Si une plateforme adopte ce modèle, il sera utile de voir si elle rend publiques les procédures reliant ses résultats de classification aux mesures prises à l’égard des contenus, ainsi que les moyens de vérifier et de corriger ces résultats.

















