
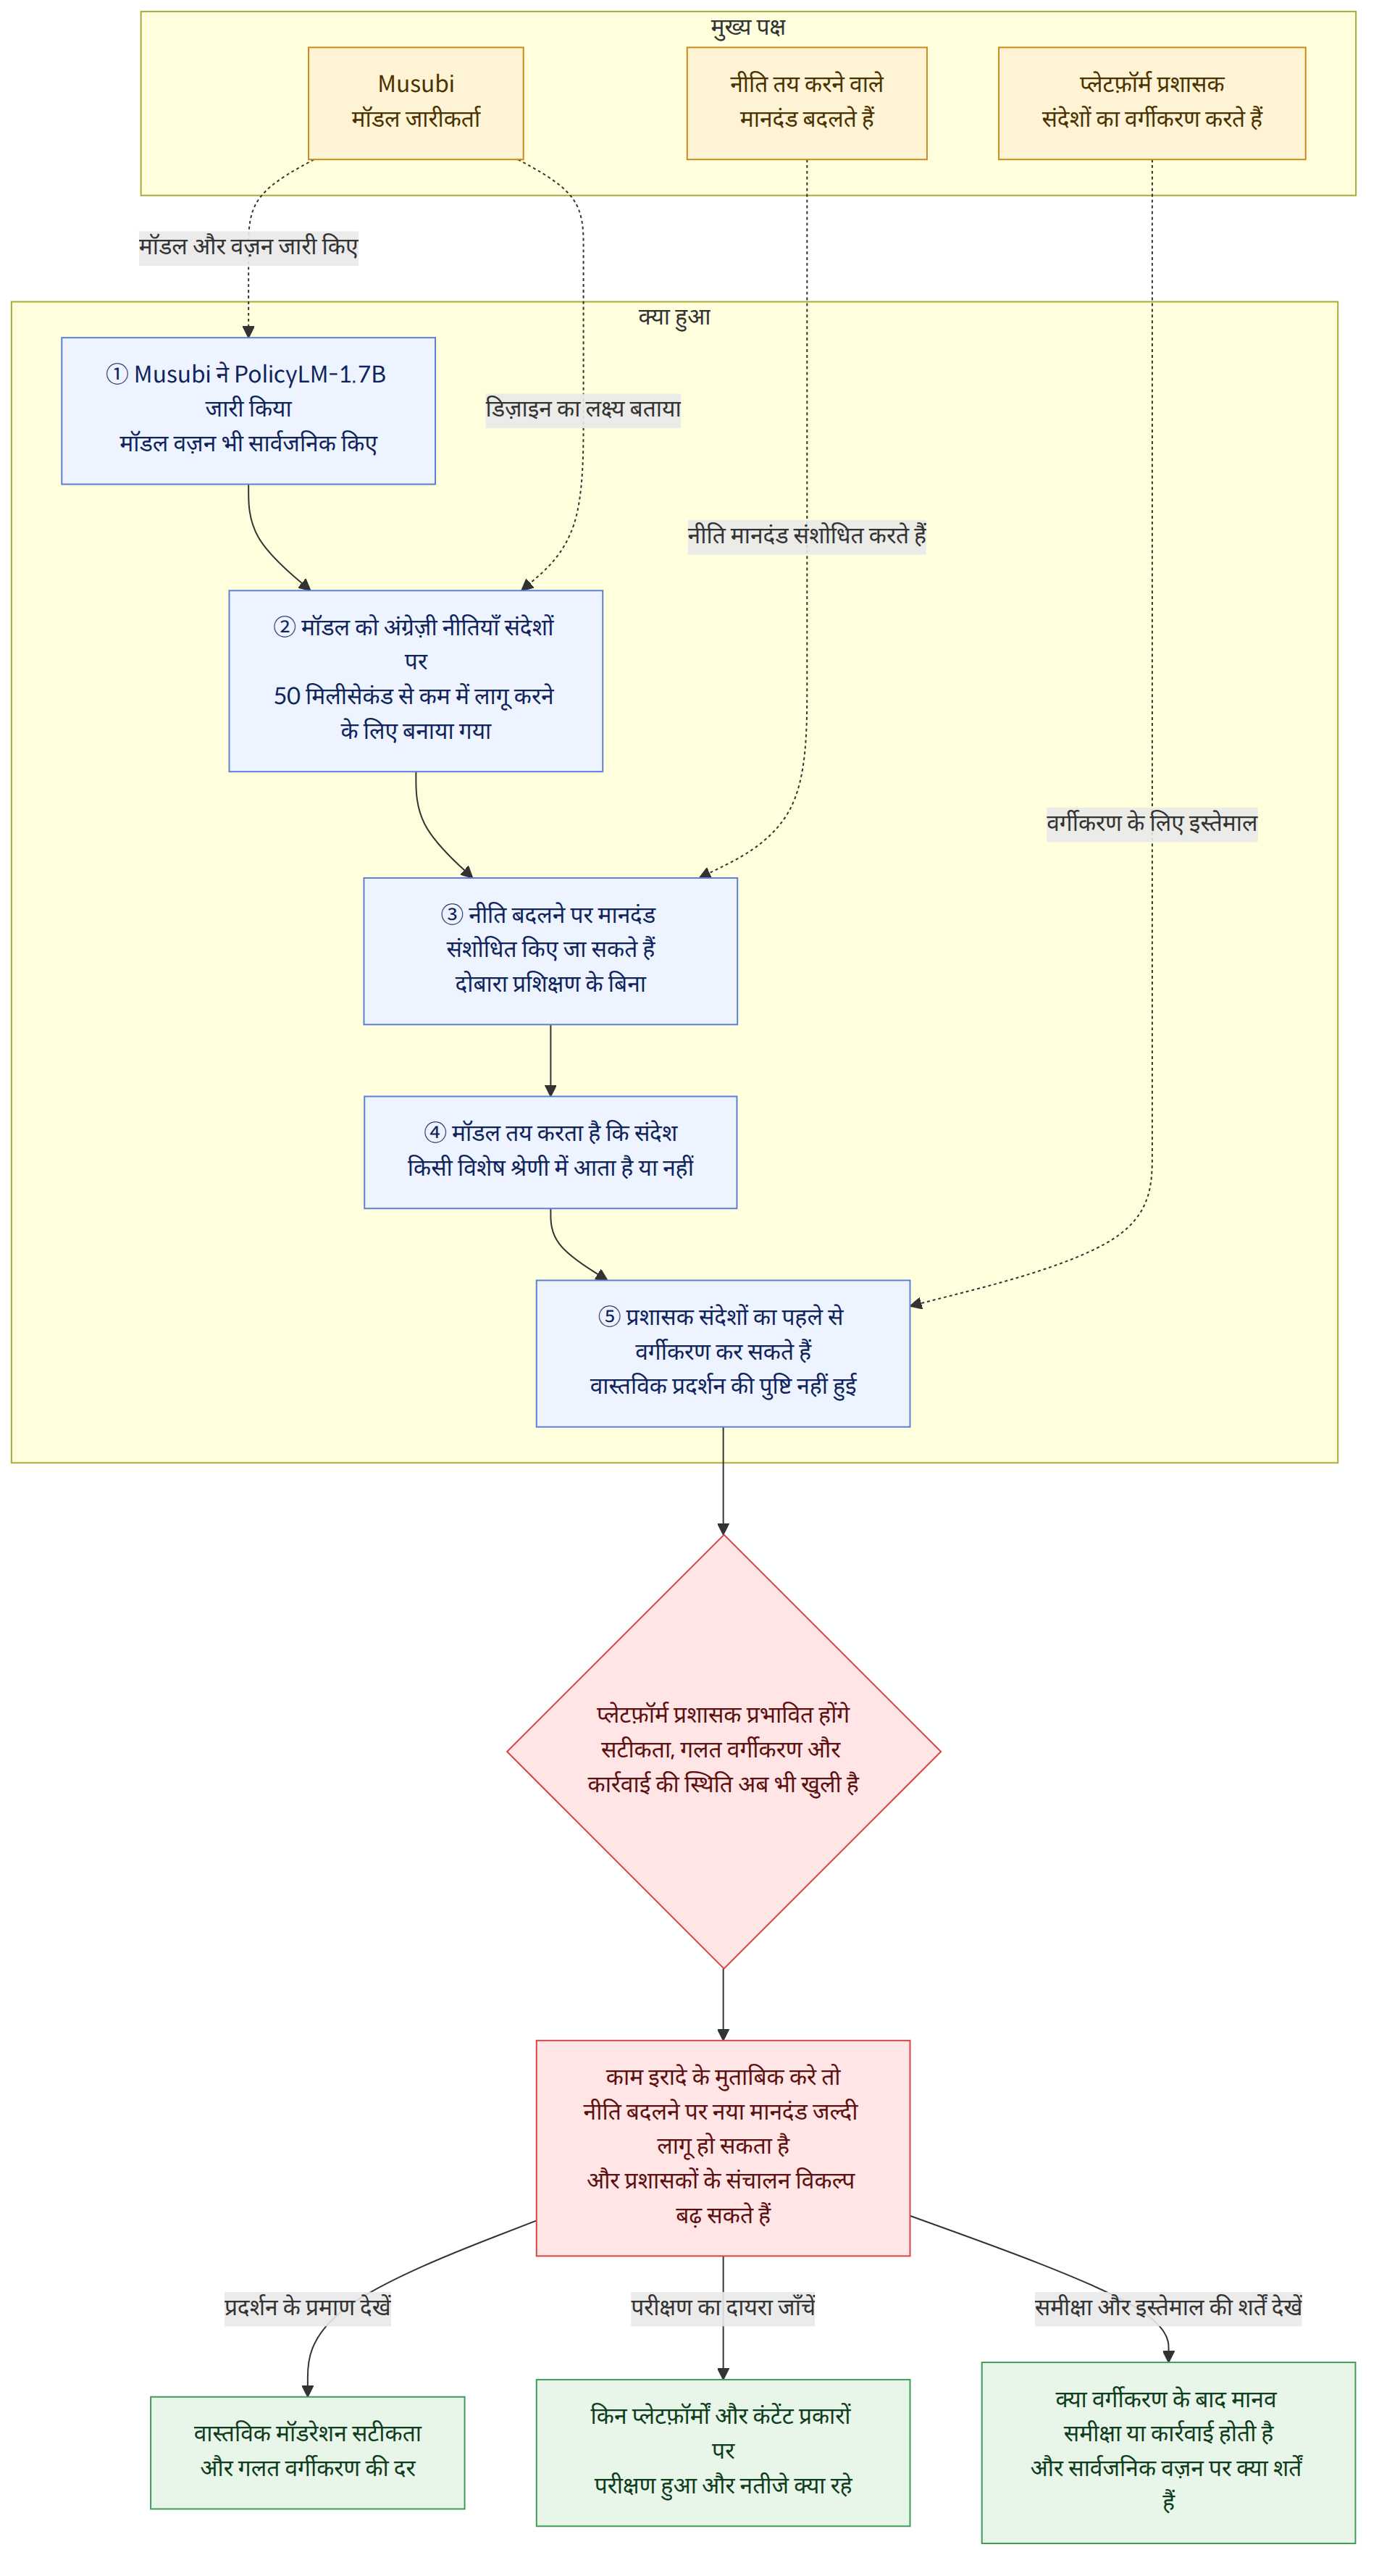
Musubi ने मंगलवार को रीयल-टाइम कंटेंट मॉडरेशन के लिए हल्का मॉडल PolicyLM-1.7B जारी किया और उसके मॉडल वज़न भी सार्वजनिक किए। कंपनी की बताई योजना के मुताबिक, मॉडल अंग्रेज़ी में लिखी कंटेंट नीतियों को संदेशों पर लागू करेगा और 50 मिलीसेकंड से कम समय में नतीजा देगा। इसकी मुख्य विशेषता यह है कि हर बार नीति बदलने पर मॉडल को नए सिरे से प्रशिक्षित किए बिना मानदंड संशोधित किए जा सकते हैं।
पृष्ठभूमि और संदर्भ
Musubi ने कहा कि PolicyLM-1.7B को इस तरह तैयार किया गया है कि इसकी लागत और गति अधिकांश सोशल प्लेटफ़ॉर्म पर कंटेंट मॉडरेशन के लिए इस्तेमाल होने वाले AI वर्गीकरण मॉडलों के समान हो। कंपनी ने यह भी बताया कि इसका लक्ष्य नवीनतम बड़े भाषा मॉडलों (LLM) की लचीलेपन का उपयोग करके जटिल नीतियों को विशेष प्रशिक्षण के बिना लागू करना है। यह विवरण मॉडल की डिज़ाइन दिशा के बारे में है; इसका अर्थ यह नहीं कि वास्तविक प्लेटफ़ॉर्मों पर समान प्रदर्शन की पुष्टि हो चुकी है।
कंपनी के विवरण के अनुसार, नीति तय करने वाले लोग मानदंड बदलते समय मॉडल को हर बार दोबारा प्रशिक्षित किए बिना ज़रूरत के अनुसार नीति में बार-बार संशोधन कर सकते हैं। यह कंटेंट मॉडरेशन में ‘फ़ैसले का मानदंड बदलने’ और ‘मॉडल को दोबारा प्रशिक्षित करने’ को अलग रखने का तरीका है। जब कंटेंट की मात्रा बढ़ रही हो और नीतियों में भी बदलाव हो सकता हो, तब इससे उस व्यवस्था की तुलना में संचालन में बदलाव जल्दी आज़माने की गुंजाइश मिल सकती है जिसमें नया मानदंड लागू करने के लिए दोबारा प्रशिक्षण अनिवार्य हो।
इस मॉडल की श्रेणी के निर्णय मॉडलों को सामान्य बड़े भाषा मॉडलों की तरह वाक्य बनाने के बजाय, तय विकल्पों के अनुसार नतीजे देने के लिए तैयार किया जाता है। मूल लेख बताता है कि निर्णय मॉडल आम तौर पर नतीजे की संभावना बताते हैं, जबकि PolicyLM-1.7B यह द्विआधारी फ़ैसला देता है कि कंटेंट किसी विशेष श्रेणी में आता है या नहीं। मूल लेख के मुताबिक, नतीजों के विकल्प सीमित करने से ट्रांसफ़ॉर्मर संरचना का लचीलापन बरकरार रखते हुए बड़े भाषा मॉडल की तुलना में इसे तेज़ी और कम लागत में चलाया जा सकता है।
मूल लेख के अनुसार, TypeSafe AI द्वारा सितंबर में Jev जारी किए जाने के बाद निर्णय मॉडलों पर ध्यान बढ़ा, और OpenAI तथा Amazon ने भी प्रतिस्पर्धी मॉडल जारी किए। Musubi के सह-संस्थापक और मुख्य AI अधिकारी फिलिप यांकोविच ने कहा कि इस तरीके में उनकी दिलचस्पी Jev के जारी होने से पहले ही शुरू हो गई थी। उन्होंने 2024 के प्रोजेक्ट GLiNER को इसकी शुरुआत बताया, जिसमें इसी तकनीक के कई रूप इस्तेमाल किए गए थे।
इस ख़बर का मतलब
कंटेंट मॉडरेशन में नीतियाँ तय करने के साथ-साथ प्लेटफ़ॉर्म पर आने वाले संदेशों को उन मानदंडों के अनुसार वर्गीकृत करना भी शामिल है। अगर PolicyLM-1.7B की डिज़ाइन इरादे के मुताबिक काम करती है, तो नीति बदलने पर मॉडल के दोबारा प्रशिक्षण का इंतज़ार किए बिना नया मानदंड लागू किया जा सकता है। इससे बड़ी मात्रा में कंटेंट संभालने वाले प्लेटफ़ॉर्म प्रशासकों के लिए संचालन के विकल्प बढ़ सकते हैं। यांकोविच ने बताया कि यह मॉडल प्रशासकों को कंटेंट का पहले से वर्गीकरण करने का तरीका देता है।
हालाँकि, ‘वर्गीकरण’ और ‘दंडात्मक कार्रवाई’ एक ही बात नहीं हैं। मूल लेख में मॉडल के नतीजे को इस फ़ैसले के रूप में बताया गया है कि कंटेंट किसी विशेष श्रेणी में आता है या नहीं। मूल लेख से यह पता नहीं चलता कि यह फ़ैसला वास्तव में पोस्ट हटाने या उपयोगकर्ता पर प्रतिबंध लगाने की ओर ले जाता है या नहीं, अथवा कोई व्यक्ति नतीजों की समीक्षा करता है या नहीं। इसलिए यह स्पष्ट रखना ज़रूरी है कि मॉडल को नीतिगत मानदंडों के अनुसार कंटेंट का वर्गीकरण करने वाले उपकरण के रूप में पेश किया गया है; यह मान लेना ठीक नहीं होगा कि इससे किसी भी कंटेंट पर कार्रवाई अपने-आप होने लगेगी।
मिसाल के लिए, अगर कोई प्लेटफ़ॉर्म अपनी मौजूदा नीति के शब्द बदलकर नया मानदंड लागू करना चाहता है, तो Musubi के विवरण के अनुसार वह मॉडल को दोबारा प्रशिक्षित किए बिना नीति में ही संशोधन करके उसे लागू कर सकता है। इससे प्रशासकों के लिए मानदंड में बदलाव कर उसे लागू करने की प्रक्रिया सरल होने की संभावना दिखती है। लेकिन उपलब्ध जानकारी के आधार पर यह तय नहीं किया जा सकता कि मॉडल बदले हुए मानदंड को कितनी सटीकता से लागू करेगा या गलत वर्गीकृत कंटेंट को कैसे सुधारा जाएगा।
पुष्ट तथ्य और वे बातें जो अभी अज्ञात हैं
पुष्ट तथ्य
- Musubi ने मंगलवार को PolicyLM-1.7B जारी किया और उसके मॉडल वज़न भी सार्वजनिक किए।
- इस मॉडल को अंग्रेज़ी में लिखी कंटेंट नीतियों को संदेशों पर 50 मिलीसेकंड से कम समय में लागू करने के लिए तैयार किया गया है।
- Musubi के मुताबिक, नीति बदलने पर ज़िम्मेदार लोग दोबारा प्रशिक्षण के बिना उसमें संशोधन कर सकते हैं।
- PolicyLM-1.7B को यह द्विआधारी फ़ैसला देने वाले मॉडल के रूप में पेश किया गया है कि कंटेंट किसी विशेष श्रेणी में आता है या नहीं।
वे बातें जो अभी अज्ञात हैं
- वास्तविक मॉडरेशन सटीकता और गलत वर्गीकरण की दर कितनी है?
- इसका परीक्षण किन प्लेटफ़ॉर्मों या कंटेंट प्रकारों पर किया गया और नतीजे क्या रहे?
- सार्वजनिक किए गए मॉडल वज़न के इस्तेमाल पर कौन-सी शर्तें या पाबंदियाँ लागू होती हैं?
पाठकों को किन बातों पर ध्यान देना चाहिए
- अगर वास्तविक इस्तेमाल या प्रदर्शन के मूल्यांकन की और ख़बरें आती हैं, तो सटीकता के साथ-साथ कंटेंट के गलत वर्गीकरण की दर और परीक्षण के माहौल को भी देखना चाहिए।
- जो लोग सार्वजनिक किए गए वज़न का सीधे उपयोग करना चाहते हैं, उन्हें लागू इस्तेमाल की शर्तें और पाबंदियाँ जाँचनी चाहिए। मौजूदा मूल लेख इन शर्तों का विवरण नहीं देता।
- अगर कोई प्लेटफ़ॉर्म यह मॉडल अपनाता है, तो यह देखना भी उपयोगी होगा कि मॉडल के वर्गीकरण नतीजे वास्तविक कंटेंट कार्रवाई तक किस प्रक्रिया से पहुँचते हैं और उन नतीजों की समीक्षा तथा संशोधन कैसे किया जा सकता है, इसकी जानकारी सार्वजनिक की जाती है या नहीं।

















