
OpenAI applicherà un watermark invisibile ai testi generati da ChatGPT e Codex nell’Unione europea (UE). In un post sul blog pubblicato lunedì, l’azienda ha dichiarato che lo introdurrà nelle prossime settimane per gli utenti idonei nell’UE. La misura riguarderà gli utenti idonei di tutti i piani, ma i criteri specifici di idoneità non sono stati indicati nelle informazioni pubblicate.
Contesto
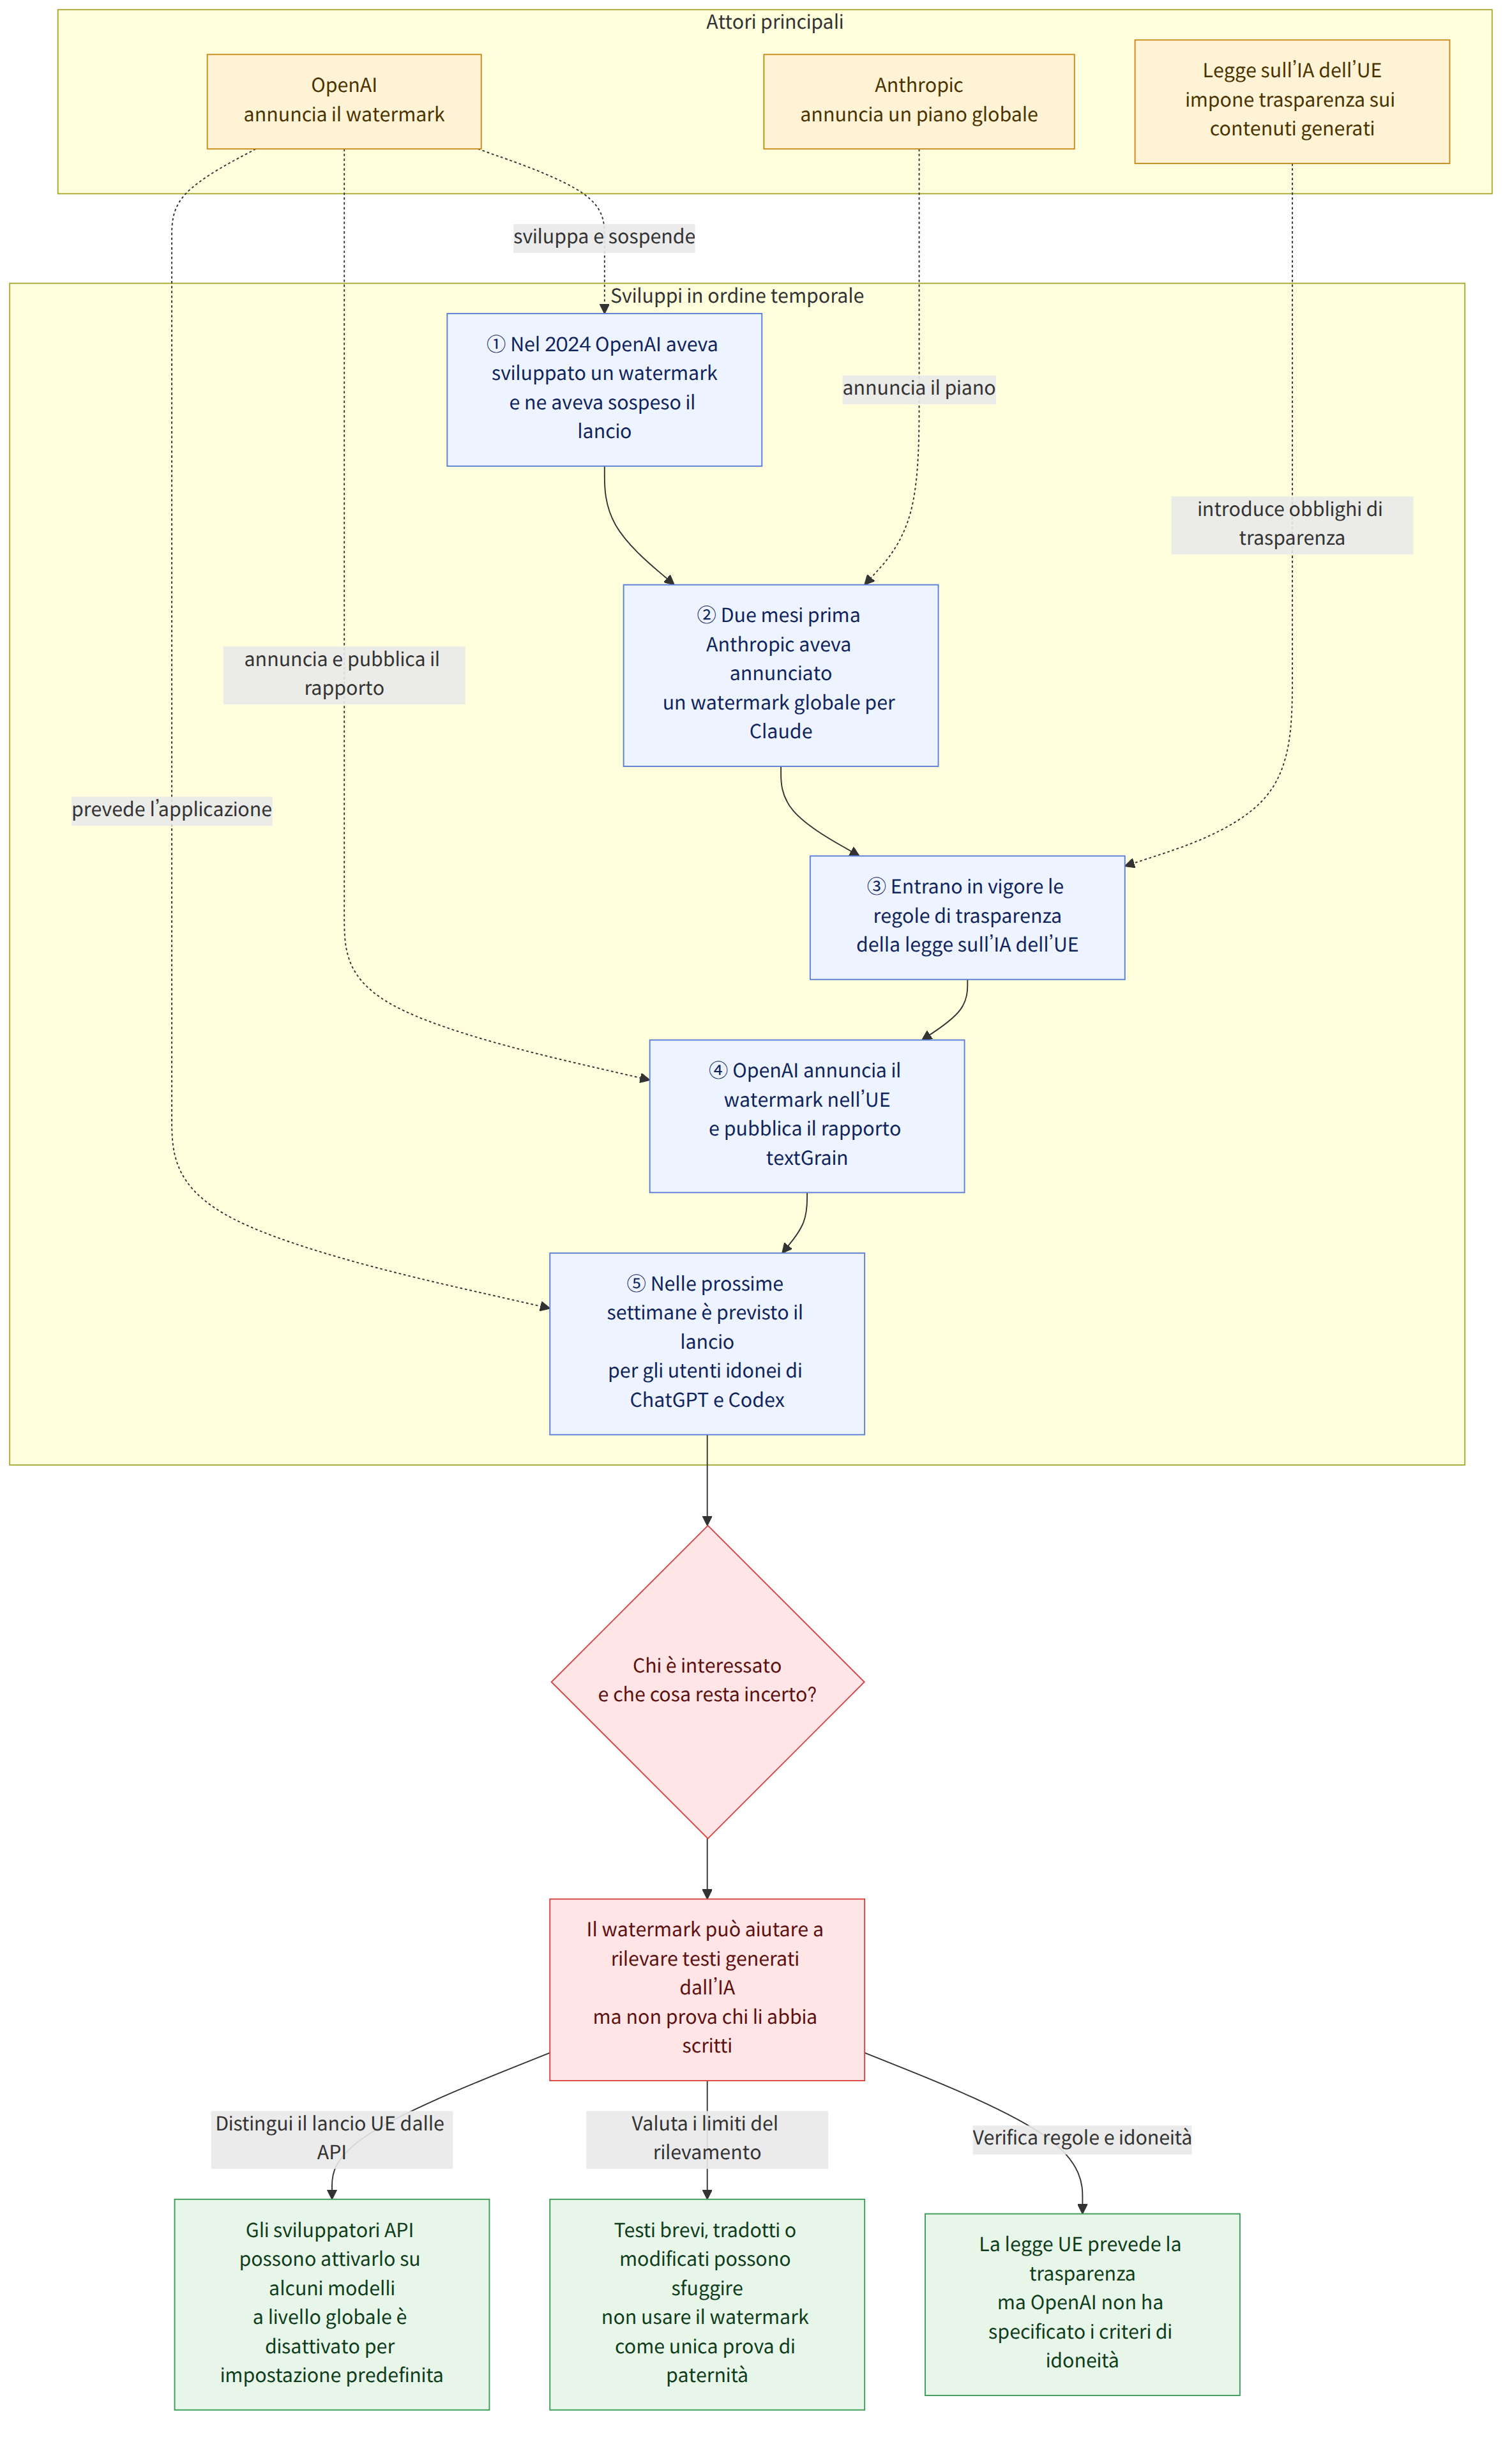
Le regole di trasparenza della legge sull’IA dell’UE (EU AI Act) sono entrate in vigore il 2 agosto e impongono alle aziende di IA di contrassegnare i contenuti generati dall’IA in modo che possano essere identificati da altri sistemi. OpenAI ha dichiarato che, in risposta a queste regole, applicherà il watermark nell’UE.
Il watermark non consiste nell’inserire nel testo un simbolo visibile. Il modello modifica in modo impercettibile il modo in cui sceglie le parole, creando un pattern riconoscibile da un rilevatore. Poiché lascia tracce nel testo stesso, il watermark viene mantenuto anche quando il testo viene copiato e incollato; OpenAI ha tuttavia spiegato che questo metodo non identifica l’utente.
Insieme all’annuncio, OpenAI ha pubblicato il rapporto tecnico textGrain. Scritto congiuntamente da ricercatori dell’Università della Pennsylvania (펜실베이니아대학교) e dell’Università di Yale (예일대학교), il rapporto descrive un metodo che usa una chiave segreta per orientare la previsione della parola successiva. Secondo il rapporto, quando queste modifiche si accumulano per centinaia di parole, è possibile rilevare contenuti generati dall’IA utilizzando il testo e la chiave. OpenAI ha dichiarato che l’attivazione del watermark non ha prodotto cambiamenti significativi nelle prestazioni del modello.
La misura si distingue anche dagli approcci adottati da altre aziende. Due mesi prima, Anthropic aveva annunciato l’intenzione di applicare un watermark a livello globale ai testi generati da Claude; secondo quanto riferito, alcuni utenti avevano protestato sostenendo di aver fornito istruzioni, contesto e decisioni. Nel 2024 era stato riportato che OpenAI aveva sviluppato un watermark testuale, ma ne aveva sospeso il lancio, tra le altre ragioni, per il timore che gli utenti potessero passare a concorrenti i cui sistemi non ne erano dotati. Anthropic, Google, Meta, Microsoft e OpenAI figurano tra le aziende che si sono impegnate a rispettare il codice di buone pratiche dell’UE (EU 실천 강령) sui contenuti generati dall’IA.
Che cosa significa questa notizia
Per gli utenti dell’UE potrebbe esserci un indizio utile a identificare i testi generati dall’IA. Tuttavia, il watermark non è un segno che consenta sempre di riconoscere con certezza ogni testo. In uno dei test di OpenAI, la sostituzione con sinonimi del 10% delle parole ha ridotto il tasso di rilevamento da circa il 92% al 66%. L’azienda ha dichiarato che anche i testi brevi, le risposte di matematica e i testi tradotti possono essere difficili da rilevare.
Di conseguenza, i risultati del rilevamento hanno dei limiti se usati come unica prova per stabilire la paternità di un testo o accertare una violazione. L’assenza del watermark non dimostra che il testo sia stato scritto da una persona: potrebbe essere troppo breve o essere stato modificato ampiamente, oppure potrebbe essere stato generato dall’IA di un’altra azienda. Al contrario, la presenza del watermark può indicare che un sistema OpenAI ha generato o elaborato una parte del testo, ma non mostra quanto vi abbiano contribuito il giudizio, le modifiche o la creatività di una persona.
Per esempio, se un rilevatore non trova il watermark in un testo, è difficile concludere, sulla sola base di questo risultato, che sia stato scritto da una persona. Occorre tenere conto anche della lunghezza del testo, del livello di modifica e della possibilità che siano stati utilizzati altri strumenti di IA.
Al di fuori dell’applicazione nell’UE, gli sviluppatori che usano le API di OpenAI in tutto il mondo possono attivare il watermark per alcuni modelli. L’impostazione predefinita è tuttavia disattivata e OpenAI ha dichiarato che, al momento del lancio, il watermark testuale non sarà attivato per impostazione predefinita a livello globale. È quindi necessario distinguere l’applicazione agli utenti dell’UE dall’uso facoltativo da parte degli sviluppatori API.
Fatti accertati e aspetti ancora incerti
Fatti accertati
- L’applicazione è prevista nelle prossime settimane per gli utenti idonei di ChatGPT e Codex nell’UE.
- Nell’UE la misura sarà applicata agli utenti idonei di tutti i piani.
- Gli sviluppatori API possono attivare il watermark per alcuni modelli in tutto il mondo, ma l’impostazione predefinita è disattivata.
- Il watermark lascia un pattern invisibile nella scelta delle parole e non identifica l’utente.
- Inizialmente l’accesso al rilevatore sarà riservato a ricercatori e organizzazioni professionali approvati, che potranno contribuire a valutarne l’affidabilità e l’uso responsabile.
Aspetti ancora incerti
- Quali sono i criteri specifici per definire un «utente idoneo» nell’UE?
- Da quando i ricercatori e le organizzazioni professionali approvati potranno usare il rilevatore?
- Quali sono i modelli specifici a cui sarà applicato il watermark e il relativo calendario di lancio?
Che cosa dovrebbero verificare i lettori
- Se si usa ChatGPT o Codex nell’UE, è opportuno verificare se il proprio account rientra tra quelli interessati e quando il servizio prevede di applicare la misura. Le informazioni disponibili non specificano i criteri dettagliati di idoneità.
- Se occorre stabilire chi ha scritto un testo, è importante non basarsi esclusivamente sul risultato del rilevamento del watermark. OpenAI ha dichiarato che inizialmente l’accesso al rilevatore sarà riservato a ricercatori e organizzazioni professionali approvati.
- Gli sviluppatori che usano le API devono verificare che il watermark sia disattivato per impostazione predefinita e che sia previsto solo per alcuni modelli. Le informazioni pubblicate non permettono di conoscere l’elenco dettagliato dei modelli né il calendario.

















