
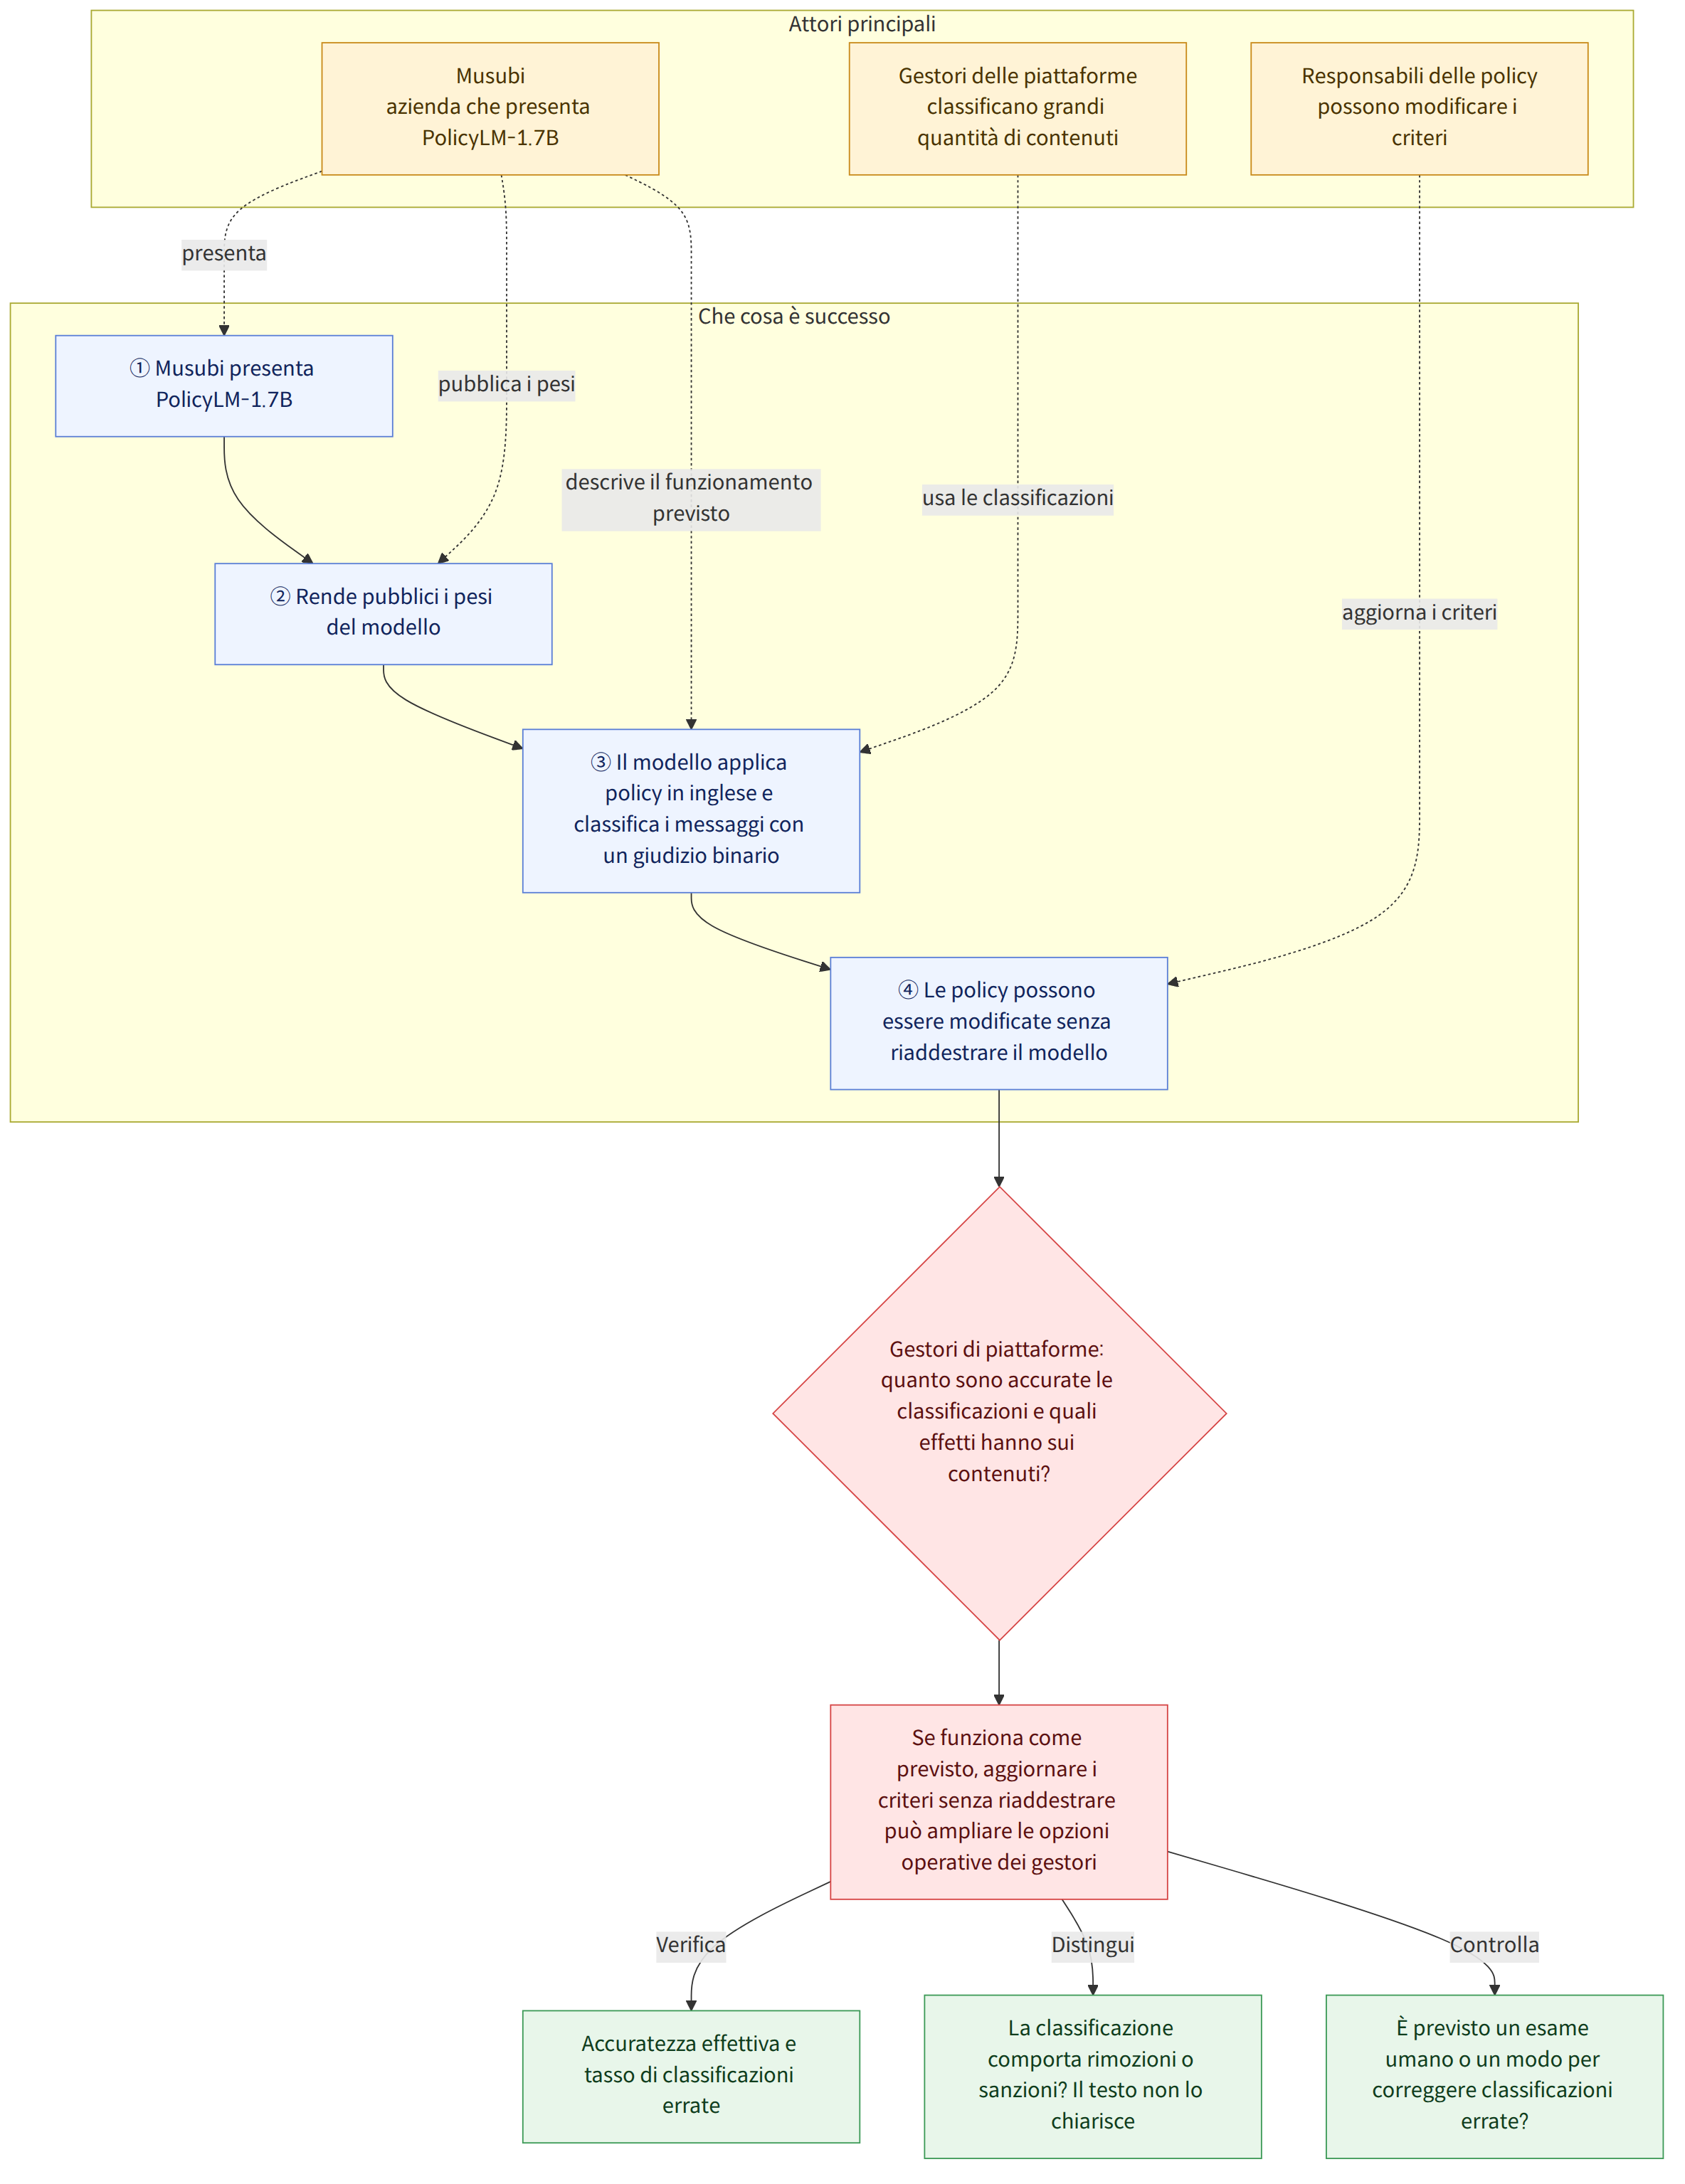
Martedì Musubi ha presentato PolicyLM-1.7B, un modello leggero per la moderazione dei contenuti in tempo reale, e ne ha reso pubblici i pesi. L’obiettivo dichiarato dall’azienda è applicare ai messaggi policy sui contenuti redatte in inglese e restituire un risultato in meno di 50 millisecondi. L’aspetto centrale è che il modello è stato progettato per consentire di modificare i criteri senza doverlo riaddestrare ogni volta che le policy cambiano.
Contesto
Musubi ha dichiarato che PolicyLM-1.7B è stato progettato per offrire costi e velocità simili a quelli dei classificatori di intelligenza artificiale usati per la moderazione dei contenuti sulla maggior parte delle piattaforme social. Al tempo stesso, l’obiettivo, ha spiegato, è sfruttare la flessibilità dei più recenti modelli linguistici di grandi dimensioni (LLM) per applicare anche policy complesse senza ricorrere a un addestramento specifico. Questa descrizione riguarda le scelte progettuali del modello e non significa che le stesse prestazioni siano state verificate su piattaforme reali.
Secondo quanto spiegato dall’azienda, chi si occupa di definire le policy può modificarle ripetutamente, quando necessario, senza dover riaddestrare ogni volta il modello. L’approccio punta a separare, nella moderazione dei contenuti, il «cambiamento dei criteri di valutazione» dal «riaddestramento del modello». In un contesto in cui i contenuti aumentano e le policy possono cambiare, questo potrebbe lasciare più spazio a modifiche operative rapide rispetto a un sistema che richiede necessariamente un nuovo addestramento per applicare criteri aggiornati.
Il modello appartiene alla categoria dei modelli decisionali, progettati per fornire risultati in base a opzioni prestabilite anziché generare testo come fanno i normali modelli linguistici di grandi dimensioni. Il testo originale spiega che i modelli decisionali di solito restituiscono la probabilità di un risultato, mentre PolicyLM-1.7B stabilisce con un giudizio binario se un contenuto appartiene o meno a una determinata categoria. Secondo il testo originale, limitare le opzioni di risposta permette di eseguire il modello in modo più rapido e meno costoso rispetto a un modello linguistico di grandi dimensioni, mantenendo al contempo la flessibilità dell’architettura transformer.
Secondo quanto riferito dal testo originale, i modelli decisionali hanno attirato l’attenzione dopo che TypeSafe AI ha presentato Jev a settembre; anche OpenAI e Amazon hanno lanciato modelli concorrenti. Philip Jankovich, cofondatore e direttore AI di Musubi, ha dichiarato di essersi interessato a questo approccio prima della presentazione di Jev. Ha indicato come origine il progetto GLiNER del 2024, che faceva ricorso a diverse tecniche analoghe.
Che cosa significa questa notizia
La moderazione dei contenuti non consiste soltanto nel definire le policy: comprende anche la classificazione dei messaggi pubblicati sulle piattaforme in base a quei criteri. Se il modello di PolicyLM-1.7B funzionasse come previsto, la possibilità di applicare nuovi criteri senza attendere il riaddestramento del modello potrebbe ampliare le opzioni operative a disposizione dei gestori delle piattaforme che trattano grandi quantità di contenuti. Jankovich ha spiegato che il modello offre ai gestori un modo per classificare i contenuti in modo proattivo.
Tuttavia, «classificazione» e «sanzione» non sono sinonimi. Il risultato descritto nel testo originale è un giudizio sull’appartenenza o meno di un contenuto a una determinata categoria. Il testo originale non chiarisce se tale giudizio comporti la rimozione effettiva di un post o sanzioni per l’utente, né se una persona esamini i risultati. È quindi importante distinguere il modello, presentato come uno strumento per classificare i contenuti in base ai criteri di moderazione, dall’affermazione che automatizzi direttamente provvedimenti relativi ai contenuti.
Per esempio, se una piattaforma volesse modificare la formulazione della policy esistente e applicare un nuovo criterio, secondo Musubi sarebbe possibile intervenire direttamente sulla policy e applicarla senza passare per il riaddestramento del modello. Ciò mostra la possibilità di semplificare il processo con cui i gestori modificano e applicano i criteri. Tuttavia, le informazioni pubblicate non consentono di stabilire con quale accuratezza il modello applichi i criteri modificati né come vengano corretti i contenuti classificati erroneamente.
Fatti confermati e aspetti ancora da chiarire
Fatti confermati
- Martedì Musubi ha presentato PolicyLM-1.7B e ne ha reso pubblici i pesi.
- Il modello è progettato per applicare policy sui contenuti in inglese ai messaggi in meno di 50 millisecondi.
- Musubi afferma che, quando le policy cambiano, chi se ne occupa può modificarle senza riaddestrare il modello.
- PolicyLM-1.7B è stato presentato come un modello che stabilisce con un giudizio binario se un contenuto appartiene a una determinata categoria.
Aspetti ancora da chiarire
- Quali sono l’accuratezza effettiva nella moderazione e il tasso di classificazioni errate?
- Su quali piattaforme o tipi di contenuto è stato testato il modello e quali sono stati i risultati?
- Quali condizioni o restrizioni si applicano all’uso dei pesi del modello resi pubblici?
Che cosa dovrebbe verificare chi legge
- Se verranno pubblicate notizie sull’adozione effettiva o valutazioni delle prestazioni, sarà importante verificare non solo l’accuratezza, ma anche la percentuale di contenuti classificati erroneamente e le condizioni in cui sono stati svolti i test.
- Chi intende utilizzare direttamente i pesi resi pubblici dovrebbe verificare le condizioni e le restrizioni applicabili. Il testo originale attualmente non ne specifica i dettagli.
- Se una piattaforma adotterà il modello, sarà utile verificare se verranno resi noti il processo con cui i risultati della classificazione portano a provvedimenti sui contenuti e i metodi per esaminare e correggere tali risultati.

















