
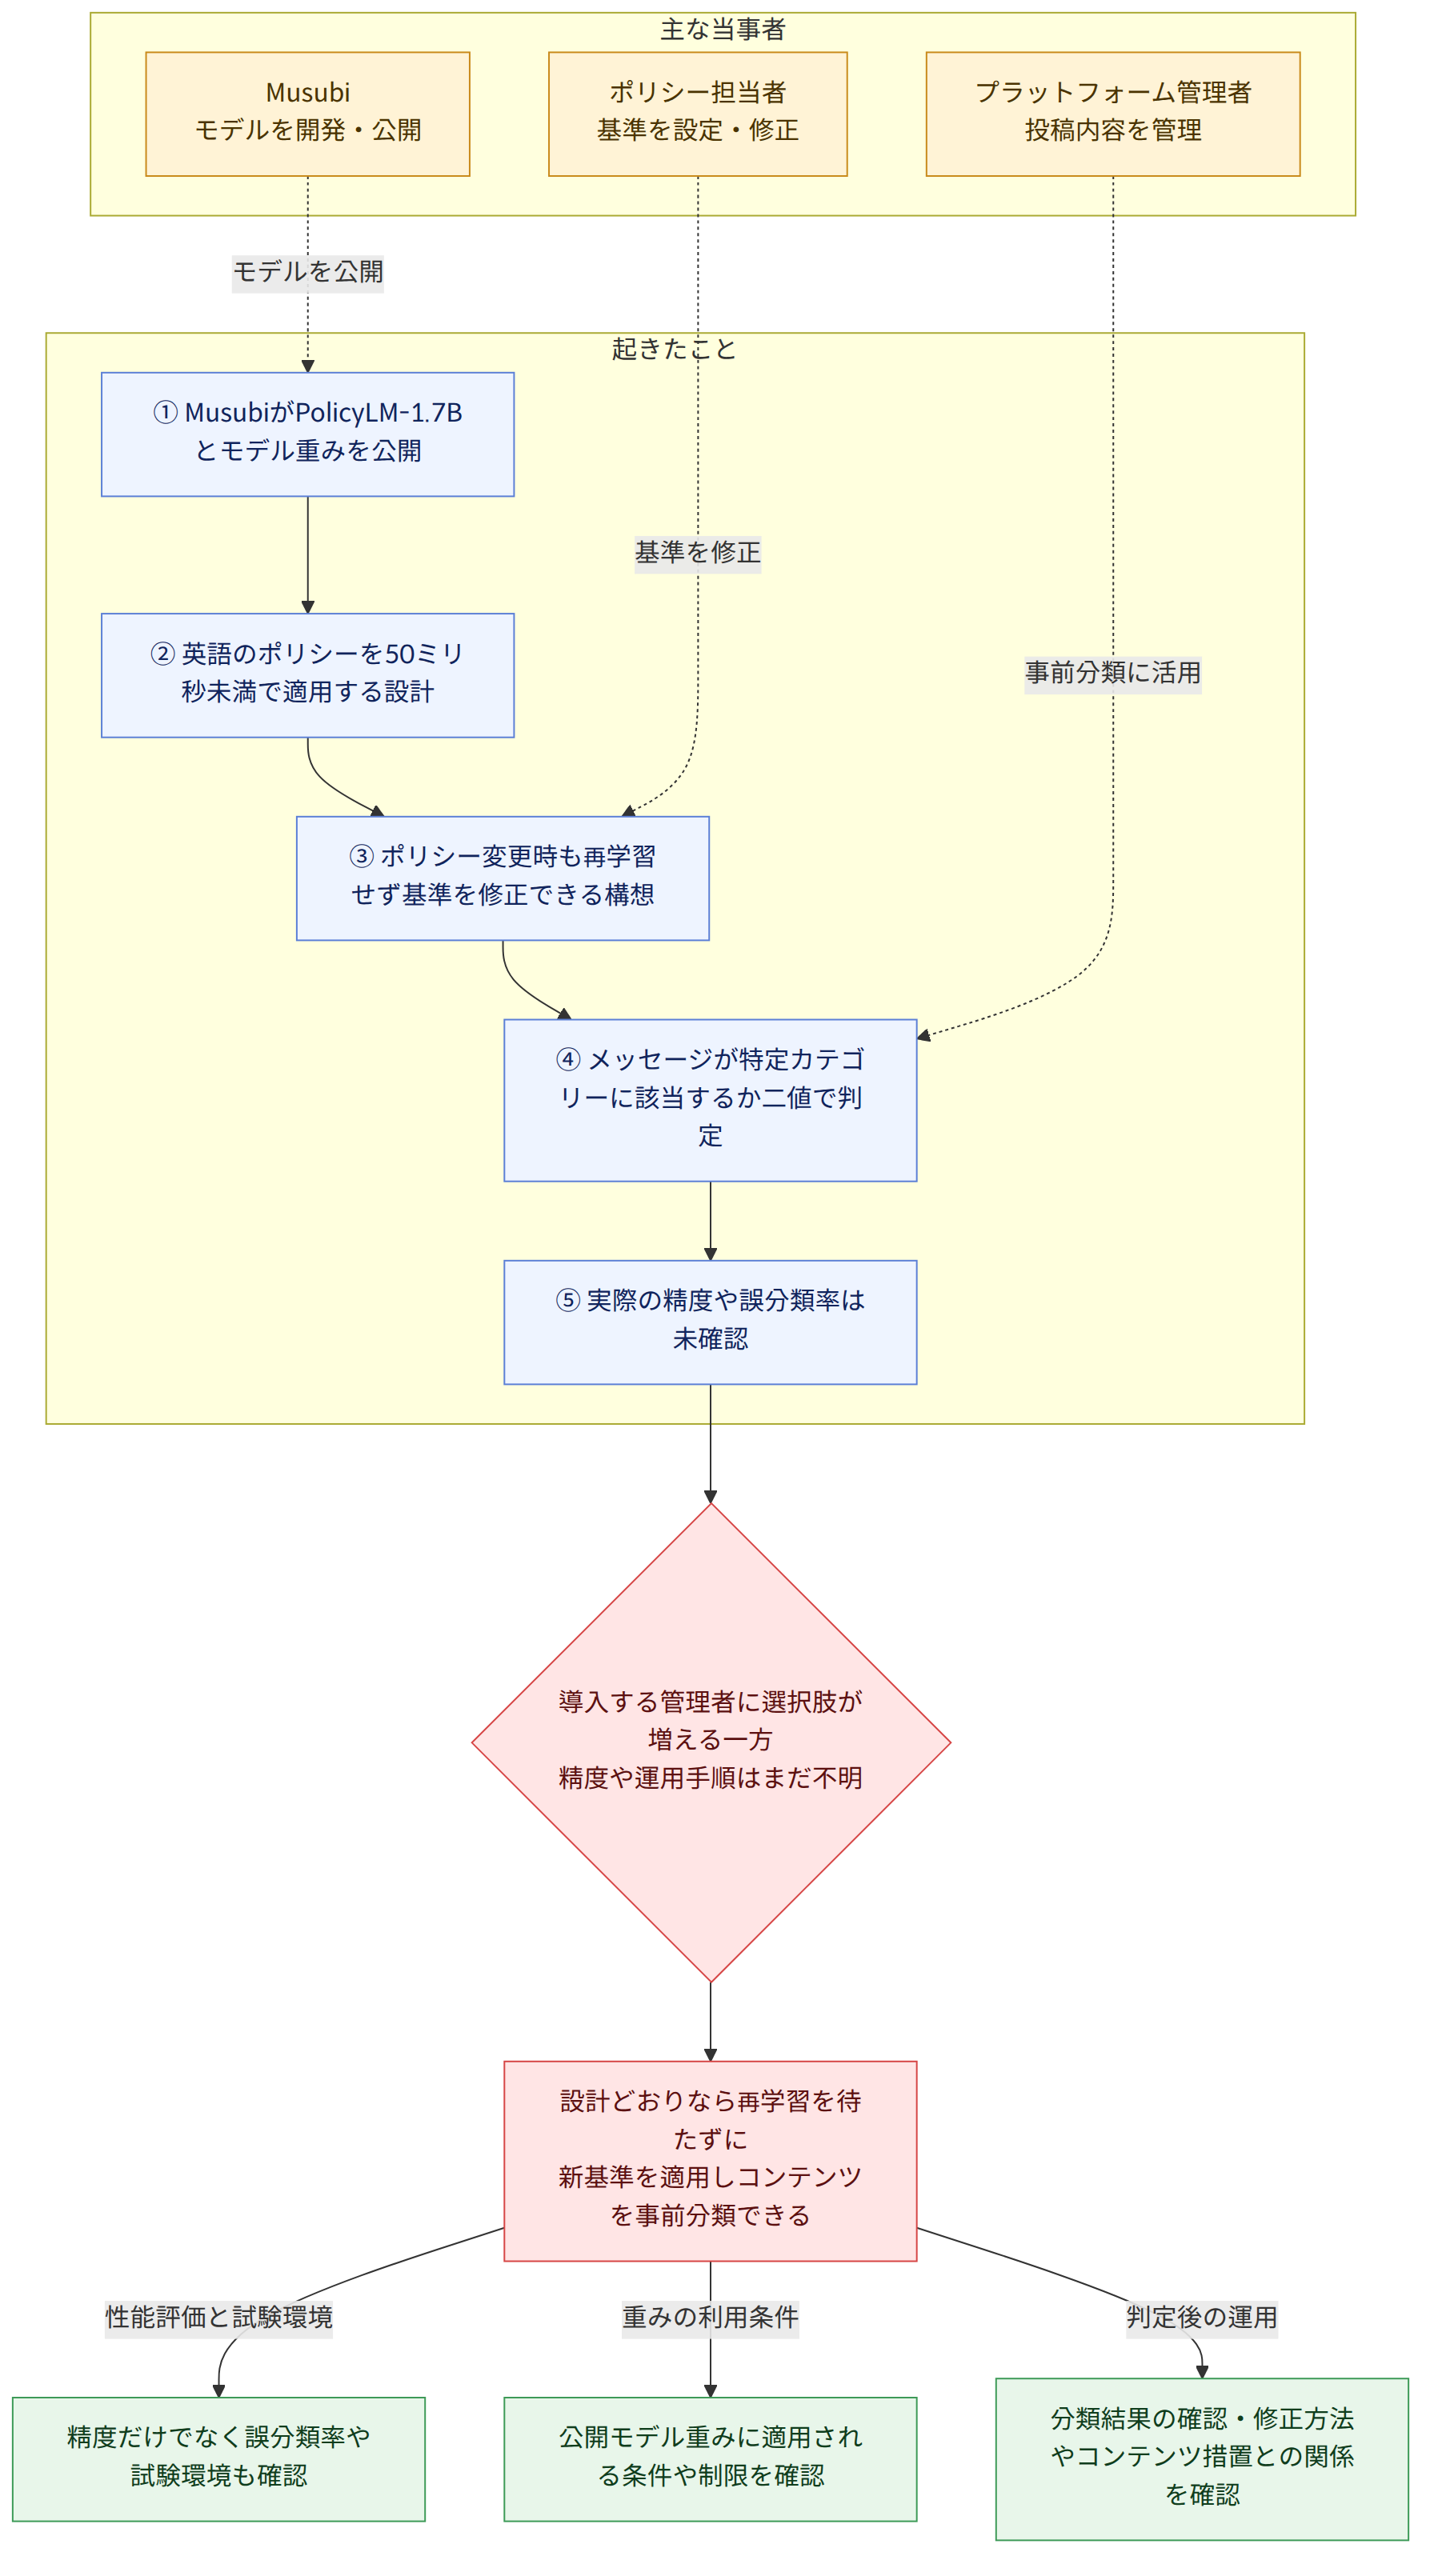
Musubiは火曜日、リアルタイムのコンテンツ判定用軽量モデルPolicyLM-1.7Bを公開し、モデル重みも公開した。同社が示す構想は、英語で書かれたコンテンツポリシーをメッセージに適用し、50ミリ秒未満で結果を出すというものだ。ポリシーが変わるたびにモデルを再学習しなくても基準を修正できるよう設計した点が、このモデルの要点だ。
背景と文脈
Musubiは、PolicyLM-1.7Bについて、ほとんどのソーシャルプラットフォームでコンテンツ判定に使われているAI分類器と同程度のコストと速度を実現するよう設計したと述べた。同時に、最新の大規模言語モデル(LLM)の柔軟性を活用し、複雑なポリシーも個別の特別な学習なしに適用することを目指していると説明した。これはモデルの設計方針に関する説明であり、実際のプラットフォームで同等の性能が確認されたという意味ではない。
同社の説明どおりであれば、ポリシーを定める担当者は、基準を変更するたびにモデルを再学習させることなく、必要に応じてポリシーを繰り返し修正できる。これは、コンテンツ判定における「判定基準の変更」と「モデルの再学習」を切り離そうとするアプローチだ。コンテンツが増え、ポリシーも調整される状況では、新しい基準の適用に再学習が必須となる仕組みよりも、運用上の変更を迅速に試せる余地が生まれる可能性がある。
このモデルが属する意思決定モデルは、一般的な大規模言語モデルのように文章を生成するのではなく、あらかじめ定められた選択肢に沿って結果を出すよう設計されたタイプだ。原文は、意思決定モデルは通常、結果の確率を出力すると説明したうえで、PolicyLM-1.7Bはコンテンツが特定のカテゴリーに該当するかどうかを二値で判定すると区別している。出力の選択肢を限定すれば、大規模言語モデルよりも高速かつ低コストで動作しながら、トランスフォーマー構造の柔軟性を保てるというのが原文の説明だ。
原文によると、意思決定モデルはTypeSafe AIが9月にJevを公開した後、注目を集め、OpenAIとAmazonも競合モデルを発表した。Musubiの共同創業者で最高AI責任者のフィリップ・ヤンコビッチは、この方式に関心を持ったのはJevの公開より前だったと述べた。彼は、同じ手法を複数活用した2024年のプロジェクトGLiNERを、その起源として挙げた。
このニュースが意味すること
コンテンツ判定には、ポリシーを定めることだけでなく、プラットフォームに投稿されるメッセージをその基準に沿って分類することも含まれる。PolicyLM-1.7Bの設計が意図どおりに機能すれば、ポリシー変更時にモデルの再学習を待たずに新しい基準を適用できるため、大量のコンテンツを扱うプラットフォームの管理者にとって、運用上の選択肢が増える可能性がある。ヤンコビッチは、このモデルによって管理者がコンテンツを事前に分類できるようになると説明した。
ただし、「分類」と「制裁」は同じではない。原文が説明しているモデルの出力は、コンテンツが特定のカテゴリーに該当するかどうかの判定だ。その判定が実際に投稿の削除や利用者への制裁につながるのか、人が結果を確認するのかといった運用手順は、原文からは確認できない。したがって、このモデルが直ちに何らかのコンテンツ措置を自動化すると断定するのではなく、判定基準に基づいてコンテンツを分類するツールとして紹介されている点を区別して見る必要がある。
たとえば、あるプラットフォームが既存ポリシーの文言を変更し、新たな基準を適用しようとする場合、Musubiの説明どおりであれば、モデルを再学習する手続きを経ずにポリシー自体を修正して適用できる。これは、運用担当者が基準を変更して適用する過程を簡素化できる可能性を示している。しかし、変更後の基準をモデルがどれほど正確に適用するのか、誤って分類されたコンテンツをどのように是正するのかは、公開された情報だけでは判断できない。
確認できた事実と、まだ分からないこと
確認できた事実
- Musubiは火曜日、PolicyLM-1.7Bを公開し、モデル重みも公開した。
- このモデルは、英語のコンテンツポリシーをメッセージに50ミリ秒未満で適用するよう設計されている。
- Musubiは、ポリシー変更時に再学習せず、担当者がポリシーを修正できると説明している。
- PolicyLM-1.7Bは、コンテンツが特定のカテゴリーに該当するかどうかを二値で判定すると紹介されている。
まだ分からないこと
- 実際の判定精度と誤分類率はどの程度なのか。
- どのようなプラットフォームやコンテンツの種類で試験され、その結果はどうだったのか。
- 公開されたモデル重みには、どのような利用条件や制限が適用されるのか。
読者が確認すべきこと
- 実際の導入事例や性能評価が追加で公表された場合は、精度だけでなく、コンテンツを誤分類する割合や試験環境も併せて確認する必要がある。
- 公開モデル重みを自ら利用する場合は、適用される利用条件や制限を確認する必要がある。現時点で原文は、その詳細な条件を示していない。
- プラットフォームがこのモデルを導入する場合、モデルの分類結果が実際のコンテンツ措置につながる手順や、結果を検証・修正する方法も公開されるか、注目したい。

















