
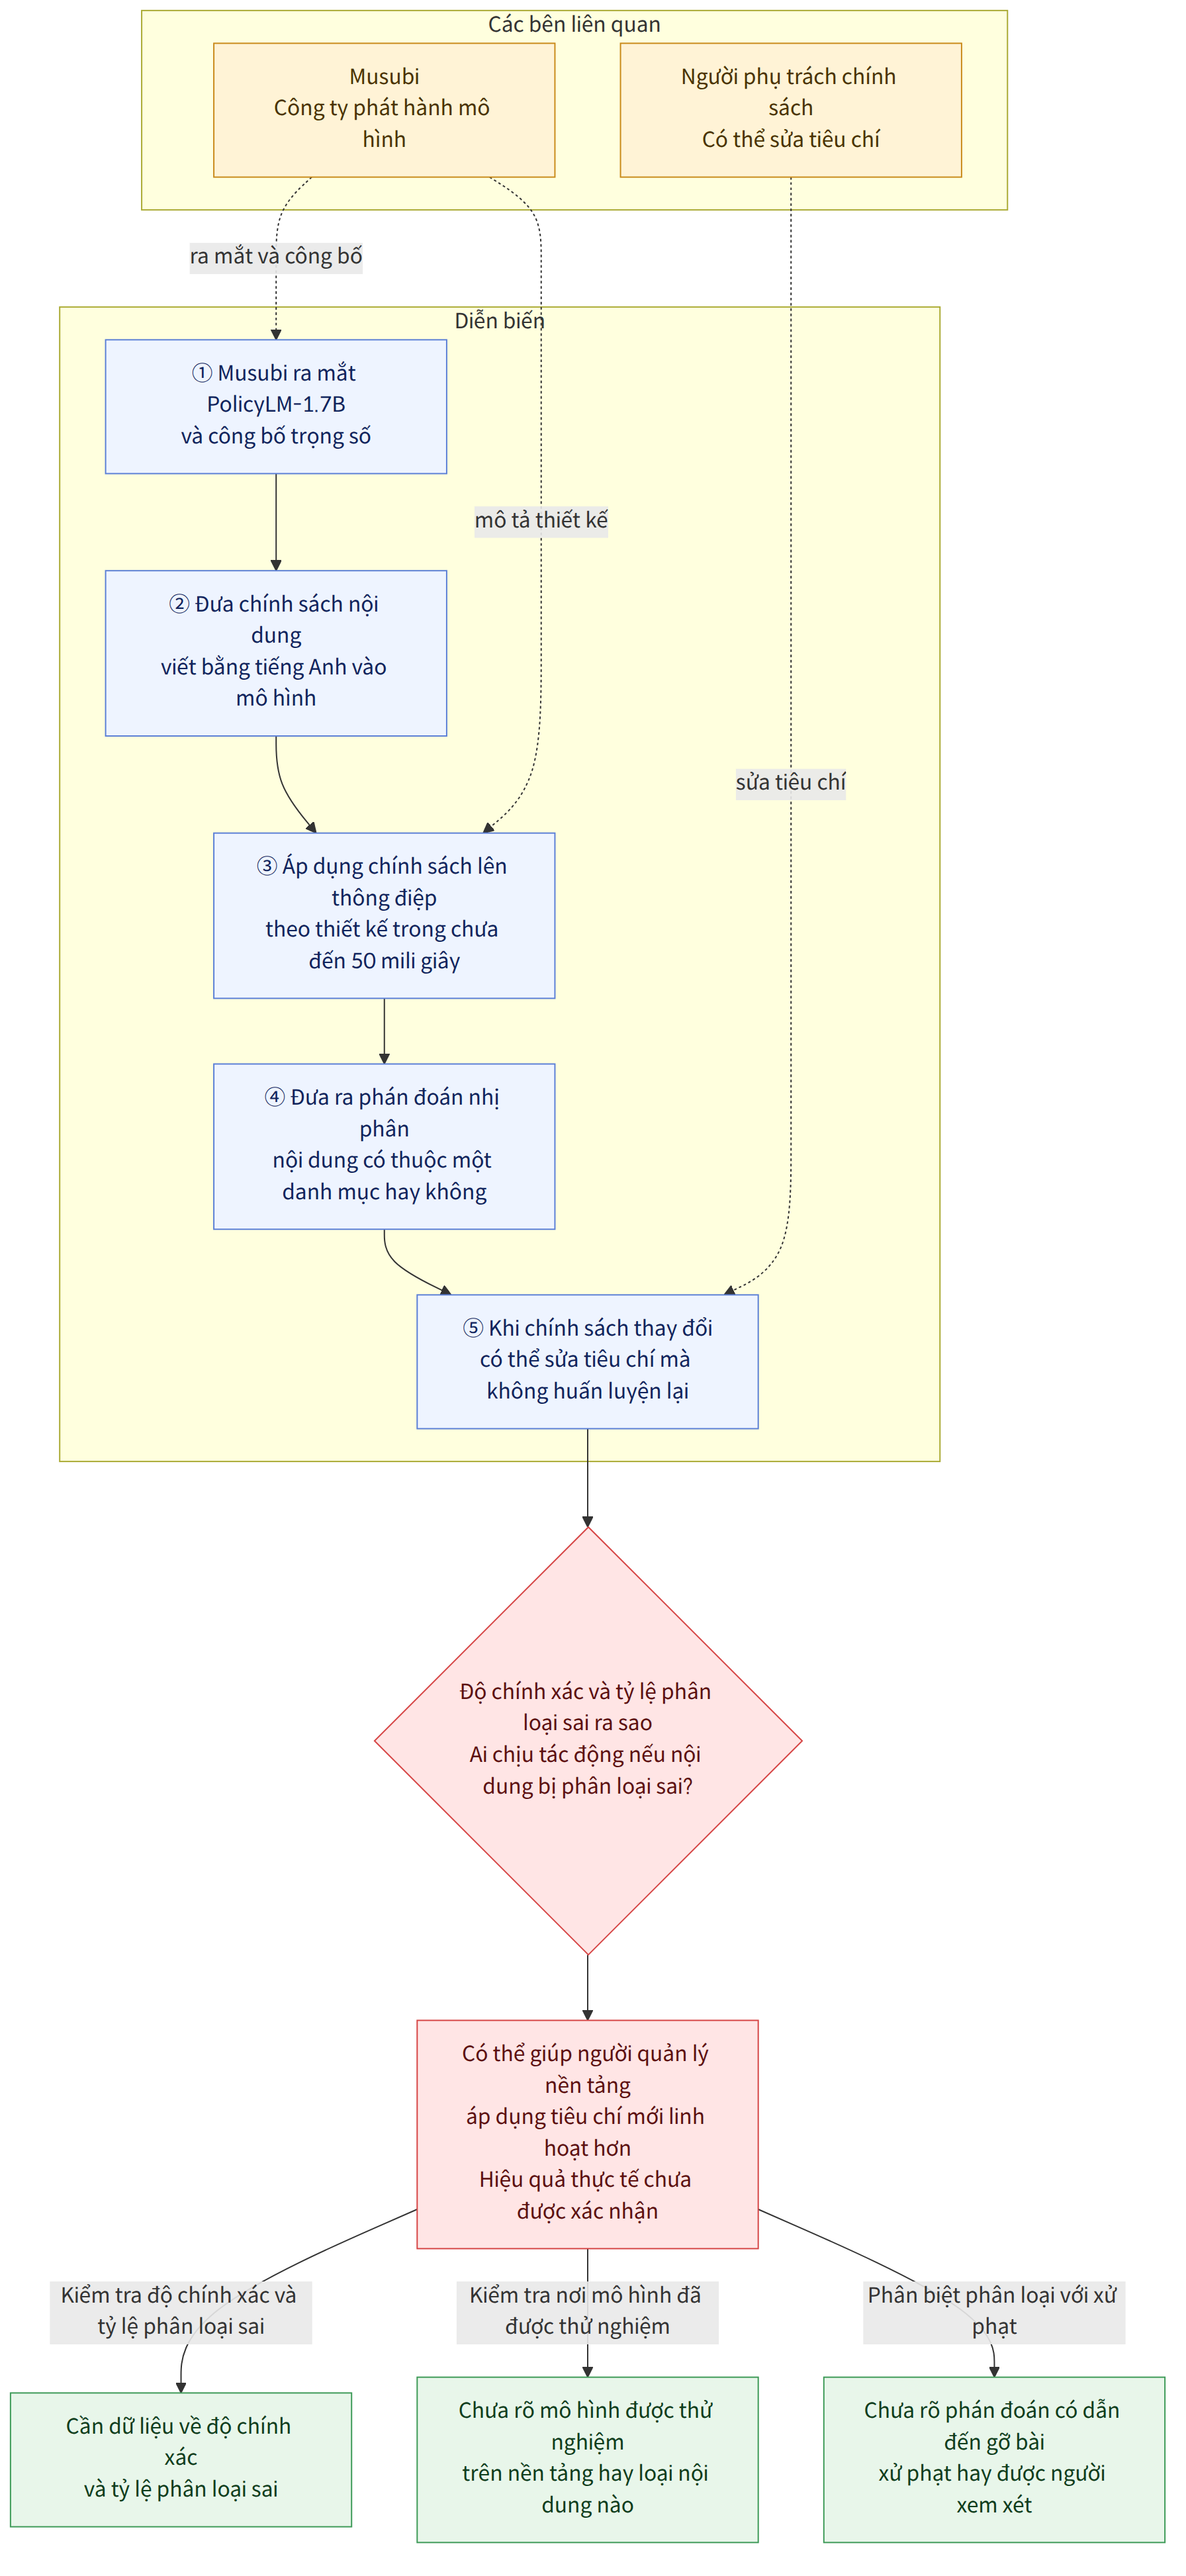
Hôm thứ Ba, Musubi ra mắt mô hình nhẹ PolicyLM-1.7B dùng để điều chỉnh nội dung theo thời gian thực và công bố cả trọng số mô hình. Theo ý tưởng mà công ty đưa ra, mô hình sẽ áp dụng các chính sách nội dung được viết bằng tiếng Anh vào thông điệp và đưa ra kết quả trong chưa đến 50 mili giây. Điểm cốt lõi là mô hình được thiết kế để có thể sửa đổi tiêu chí mà không cần huấn luyện lại mỗi khi chính sách thay đổi.
Bối cảnh
Musubi cho biết PolicyLM-1.7B được thiết kế để có chi phí và tốc độ tương tự các bộ phân loại AI dùng cho việc điều chỉnh nội dung trên hầu hết các nền tảng mạng xã hội. Đồng thời, công ty cho biết mục tiêu là tận dụng tính linh hoạt của các mô hình ngôn ngữ lớn (LLM) mới nhất để áp dụng cả những chính sách phức tạp mà không cần huấn luyện đặc biệt riêng. Đây là mô tả về định hướng thiết kế của mô hình, không có nghĩa là hiệu năng tương tự đã được xác nhận trên các nền tảng thực tế.
Theo mô tả của công ty, người phụ trách xây dựng chính sách có thể sửa đổi chính sách khi cần mà không phải huấn luyện lại mô hình mỗi lần thay đổi tiêu chí. Cách tiếp cận này nhằm tách biệt “thay đổi tiêu chí phán định” khỏi “huấn luyện lại mô hình” trong việc điều chỉnh nội dung. Khi lượng nội dung ngày càng lớn và chính sách có thể được điều chỉnh, cách làm này có thể tạo điều kiện thử nghiệm thay đổi trong vận hành nhanh hơn so với mô hình trong đó việc huấn luyện lại là bắt buộc để áp dụng tiêu chí mới.
Mô hình ra quyết định mà mô hình này thuộc về được thiết kế để đưa ra kết quả theo các lựa chọn đã định sẵn, thay vì tạo câu như các mô hình ngôn ngữ lớn thông thường. Bài viết gốc giải thích rằng mô hình ra quyết định thường đưa ra xác suất của kết quả, đồng thời phân biệt rằng PolicyLM-1.7B đưa ra phán đoán nhị phân về việc nội dung có thuộc một danh mục cụ thể hay không. Theo bài viết gốc, việc giới hạn các lựa chọn đầu ra có thể giúp mô hình chạy nhanh và rẻ hơn mô hình ngôn ngữ lớn, đồng thời vẫn duy trì tính linh hoạt của kiến trúc transformer.
Bài viết gốc cho biết các mô hình ra quyết định bắt đầu thu hút sự chú ý sau khi TypeSafe AI ra mắt Jev vào tháng 9, và OpenAI cùng Amazon cũng đã đưa ra các mô hình cạnh tranh. Philip Jankowicz, đồng sáng lập kiêm giám đốc AI của Musubi, cho biết ông đã quan tâm đến phương pháp này trước khi Jev được ra mắt. Ông nêu dự án GLiNER năm 2024, trong đó sử dụng nhiều kỹ thuật tương tự, là điểm khởi nguồn của phương pháp này.
Ý nghĩa của thông tin này
Điều chỉnh nội dung không chỉ bao gồm việc xây dựng chính sách mà còn cả việc phân loại thông điệp được đăng lên nền tảng theo các tiêu chí đó. Nếu thiết kế của PolicyLM-1.7B hoạt động đúng như dự kiến, khả năng áp dụng tiêu chí mới mà không phải chờ huấn luyện lại mô hình mỗi khi chính sách thay đổi có thể mở rộng các lựa chọn vận hành cho người quản lý nền tảng xử lý lượng lớn nội dung. Jankowicz giải thích rằng mô hình này cung cấp cho người quản lý một cách để chủ động phân loại nội dung.
Tuy nhiên, “phân loại” và “xử phạt” không đồng nghĩa. Đầu ra của mô hình như được mô tả trong bài viết gốc là phán đoán về việc nội dung có thuộc một danh mục cụ thể hay không. Bài viết gốc không cho biết phán đoán đó có thực sự dẫn đến việc xóa bài đăng hoặc xử phạt người dùng hay không, cũng như có người xem xét kết quả hay không. Vì vậy, cần phân biệt giữa việc xem đây là công cụ phân loại nội dung theo tiêu chí điều chỉnh và khẳng định rằng mô hình này tự động hóa ngay các biện pháp xử lý nội dung.
Ví dụ, nếu một nền tảng muốn sửa câu chữ trong chính sách hiện hành để áp dụng tiêu chí mới, theo mô tả của Musubi, nền tảng có thể sửa đổi và áp dụng chính sách mà không cần thực hiện quy trình huấn luyện lại mô hình. Điều này cho thấy tiềm năng đơn giản hóa quy trình người vận hành điều chỉnh và áp dụng tiêu chí. Tuy nhiên, chỉ dựa trên thông tin đã công bố thì chưa thể đánh giá mô hình áp dụng tiêu chí đã thay đổi chính xác đến mức nào, hay nội dung bị phân loại sai sẽ được khắc phục ra sao.
Những điều đã xác nhận và những điều chưa rõ
Những điều đã xác nhận
- Hôm thứ Ba, Musubi đã ra mắt PolicyLM-1.7B và công bố cả trọng số mô hình.
- Mô hình được thiết kế để áp dụng chính sách nội dung bằng tiếng Anh vào thông điệp trong chưa đến 50 mili giây.
- Musubi cho biết người phụ trách có thể sửa đổi chính sách khi chính sách thay đổi mà không cần huấn luyện lại.
- PolicyLM-1.7B được giới thiệu là mô hình đưa ra phán đoán nhị phân về việc nội dung có thuộc một danh mục cụ thể hay không.
Những điều chưa rõ
- Độ chính xác thực tế trong việc điều chỉnh nội dung và tỷ lệ phân loại sai là bao nhiêu?
- Mô hình đã được thử nghiệm trên những nền tảng hoặc loại nội dung nào, và kết quả ra sao?
- Những điều kiện hay hạn chế sử dụng nào áp dụng cho các trọng số mô hình đã công bố?
Những điều độc giả cần theo dõi
- Nếu có thêm thông tin về việc triển khai thực tế hoặc đánh giá hiệu năng, cần xem xét cả độ chính xác, tỷ lệ phân loại nhầm nội dung và môi trường thử nghiệm.
- Những ai muốn trực tiếp sử dụng các trọng số mở cần kiểm tra các điều kiện và hạn chế áp dụng. Bài viết gốc hiện không nêu chi tiết các điều kiện này.
- Nếu một nền tảng triển khai mô hình, cũng cần theo dõi xem quy trình biến kết quả phân loại của mô hình thành biện pháp xử lý nội dung thực tế có được công bố hay không, cũng như cách xem xét và sửa đổi kết quả.

















