
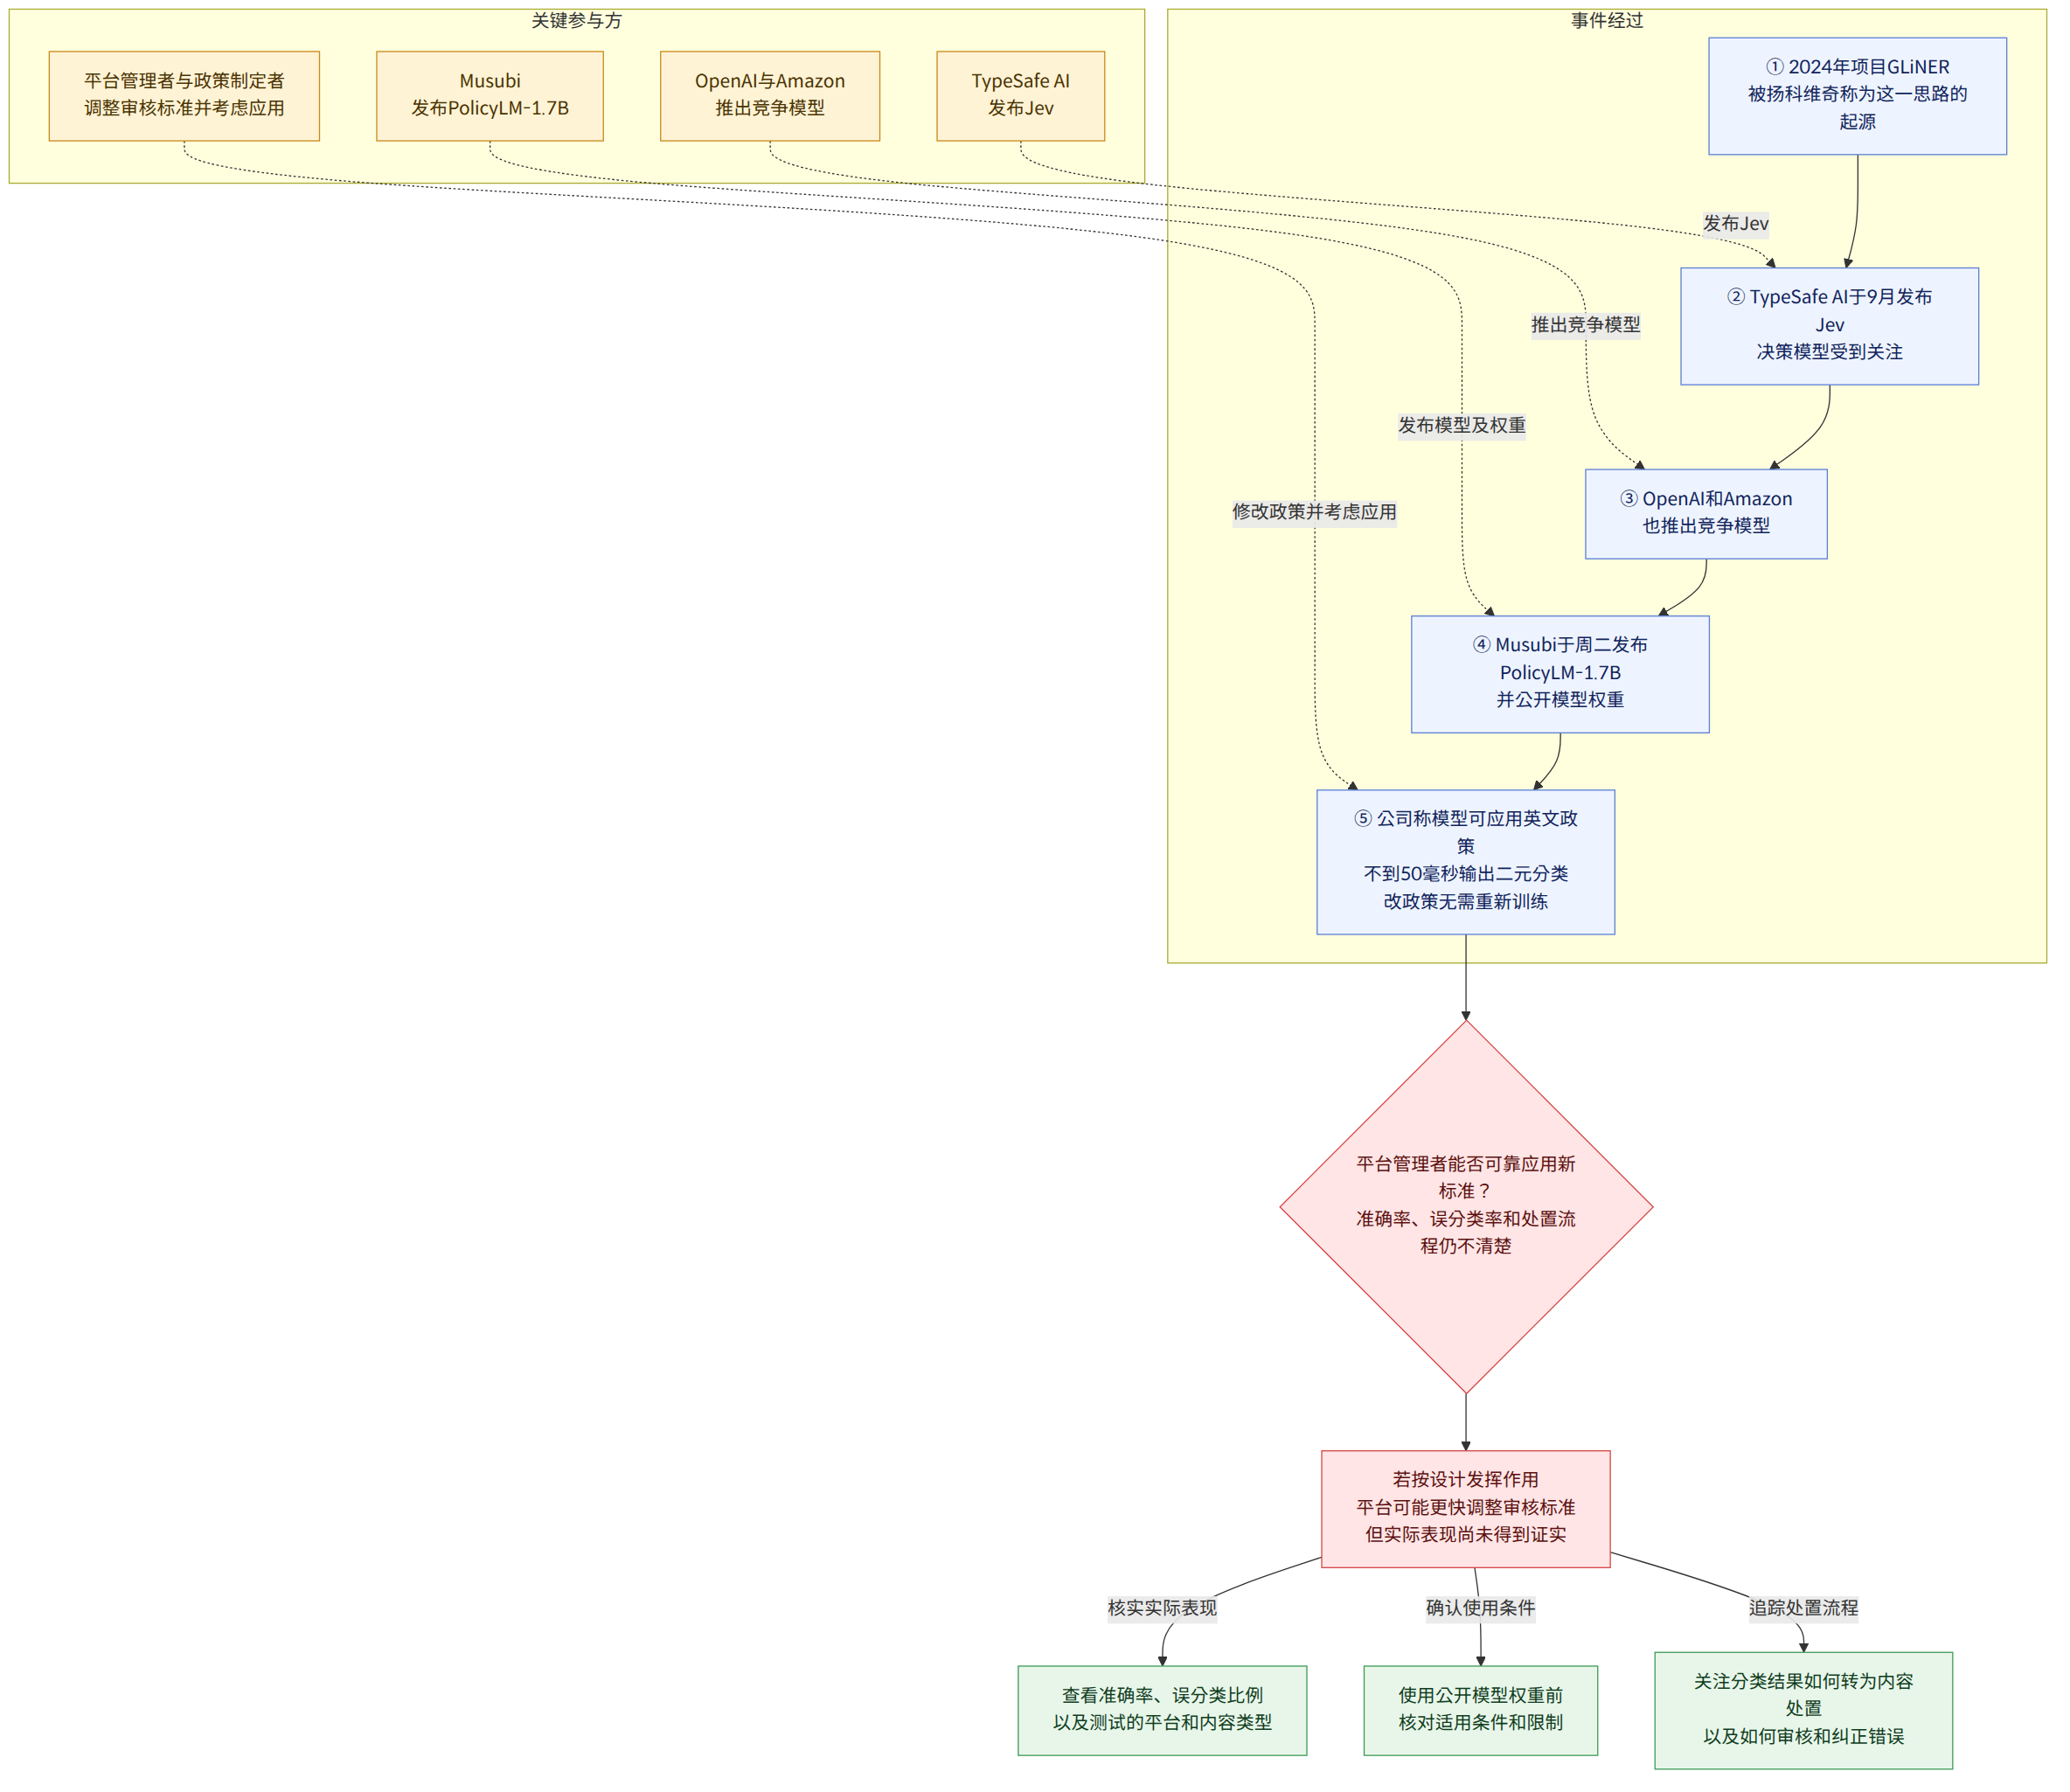
周二,Musubi发布了用于实时内容审核的轻量级模型PolicyLM-1.7B,并公开了模型权重。公司提出的方案是,将以英文撰写的内容政策应用于消息,并在不到50毫秒内得出结果。其核心特点是,政策变更时无需重新训练模型,也能调整标准。
背景与脉络
Musubi表示,PolicyLM-1.7B的设计目标是,在成本和速度上与大多数社交平台用于内容审核的AI分类器相近。同时,公司称,该模型旨在利用最新大语言模型(LLM)的灵活性,无需专门的额外训练即可应用复杂政策。这些说法描述的是模型的设计方向,并不意味着其在实际平台上已被证实能达到同等表现。
按照公司的说法,负责制定政策的人员在调整标准时,无需每次都重新训练模型,可以根据需要反复修改政策。这种做法试图将内容审核中的“改变判定标准”和“重新训练模型”分开。在内容量大、政策也可能调整的情况下,与必须重新训练才能应用新标准的模式相比,这或许能让运营方更快尝试调整。
这类决策模型不同于一般的大语言模型:它不是生成文本,而是按照预先设定的选项输出结果。原文称,决策模型通常会输出结果概率,并指出PolicyLM-1.7B有所不同,它以二元判断的方式输出内容是否属于某一特定类别。原文解释称,限制输出选项可以让模型比大语言模型运行得更快、成本更低,同时保留Transformer架构的灵活性。
原文称,TypeSafe AI于9月发布Jev后,决策模型受到关注,OpenAI和Amazon也推出了竞争模型。Musubi联合创始人兼首席AI官菲利普·扬科维奇表示,他在Jev发布之前就已对这种方法产生兴趣。他将采用了多种相同技术的2024年项目GLiNER称为这一思路的起源。
这则消息意味着什么
内容审核不仅包括制定政策,也包括按照这些标准对平台上发布的消息进行分类。如果PolicyLM-1.7B的设计能够按预期发挥作用,那么对于处理大量内容的平台管理者而言,无需等待模型重新训练就能应用新标准,可能会增加运营上的选择。扬科维奇解释称,该模型为管理者提供了一种主动对内容进行分类的方法。
不过,“分类”和“处罚”并不是一回事。原文介绍的模型输出,是判断内容是否属于某一特定类别。原文没有说明这一判断是否会直接导致删除帖子或处罚用户,也没有说明是否有人会审核模型结果。因此,与其断言该模型会立即自动执行某种内容处置,不如区分来看:它被介绍为一种按照审核标准对内容进行分类的工具。
例如,如果某个平台打算修改现有政策的措辞并应用新标准,那么按照Musubi的说法,无需重新训练模型,只要修改政策本身即可应用。这显示出简化运营人员调整并应用标准流程的可能性。不过,仅凭已公开的信息,无法判断模型对变更后的标准能否准确应用,也无法得知如何纠正被错误分类的内容。
已确认的事实与尚不清楚之处
已确认的事实
- Musubi于周二发布了PolicyLM-1.7B,并公开了模型权重。
- 该模型旨在将英文内容政策应用于消息,并在不到50毫秒内完成。
- Musubi称,政策变更时,负责人无需重新训练即可修改政策。
- PolicyLM-1.7B被介绍为以二元判断的方式输出内容是否属于某一特定类别。
尚不清楚之处
- 实际审核准确率和误分类率是多少?
- 该模型在哪些平台或内容类型中接受过测试,测试结果如何?
- 公开的模型权重适用哪些使用条件或限制?
读者可以留意的事项
- 如果后续公布了实际部署消息或性能评估,除了准确率,也有必要关注内容误分类比例以及测试环境。
- 如果打算直接使用公开权重,应确认适用的使用条件和限制。目前原文未提供这些详细信息。
- 如果平台采用该模型,也值得关注相关信息是否会公开说明:模型的分类结果通过什么流程转化为实际内容处置,以及如何审核和修正处置结果。

















